中文
教育背景
- 哈尔滨工业大学-南方科技大学 (2021-2025)
- 联合培养 博士
- 导师:何志海 (IEEE Fellow)
- 专业: 电子信息
- 德克萨斯大学 (2015-2016)
- 硕士: 信息系统
- 东北大学 (2009-2015)
- 本科:软件工程
科研经历
- 深圳大学计算机与软件学院 (07/2025 - 至今)
- 助理教授
- 剑桥大学应用数学与理论物理系 (03/2024 - 09/2024)
- 访问学者
- 南方科技大学AI Lab (03/2021 - 09/2021)
- 研究助理
业界经历
- 华为,SAP (07/2018- 07/2020)
- 软件工程师
研究兴趣
我的研究兴趣位于多模态学习、基础模型、人本智能以及面向智能系统的软件工程的交叉方向。总体而言,我关注如何构建能够高效适配、稳健泛化、可信可控、与人自然协作,并能够在真实环境中被可靠构建、部署与维护的智能系统。
过去几年,我主要研究视觉语言模型的适配、参数高效微调与泛化,重点关注基础模型在新任务、新领域和分布变化条件下,如何以更低成本实现高效迁移与稳健泛化。在这一过程中,我尤其关注结合几何、优化与结构化建模等数学工具,探索更具原理性和可解释性的多模态学习方法。
近期,我也开始关注大模型的可信性与可控性,包括 Machine Unlearning 和 Watermarking & Fingerprinting 等问题,希望推动大模型在真实应用中的安全部署、内容溯源与可靠使用。
面向未来,我尤其对第一人称视觉、第一人称智能体以及第一人称多模态大模型感兴趣。我的长远目标是构建 Human-AI Co-Embodied Intelligence,使人工智能能够从第一人称视角理解人的行为、意图与环境交互,并在人机共处的真实世界中与人共同感知、共同理解、共同演化。
更广义地说,我的软件工程背景也促使我持续思考:如何将基础模型、多模态智能与具身智能的研究进展,进一步转化为可构建、可评测、可部署、可维护的真实智能系统。
- 多模态基础模型的高效适配与泛化:研究视觉语言模型与多模态基础模型的高效适配、参数高效微调与稳健泛化,包括 LoRA、Adapters、Prompt Learning 等参数高效方法。
- 大模型的可信与可控机制:研究 Machine Unlearning、Watermarking & Fingerprinting 等方向,提升大模型在真实应用中的可控性、可追踪性与可靠性。
- 第一人称多模态智能与人机共具身智能:研究第一人称视觉、第一人称智能体和第一人称多模态大模型,探索以人为中心的感知、推理与协作机制,推动 Human-AI Co-Embodied Intelligence。
- 面向多模态与具身智能系统的软件工程:研究如何将多模态基础模型与具身智能能力系统化地组织为可构建、可测试、可部署、可维护的真实系统,重点关注模块化架构、可靠性评测、人机闭环交互与生命周期管理。
学术任职
- 期刊审稿人:TMM, Neurocomputing
- 会议审稿人:CVPR, ICLR, NeurIPS, AAAI, ECCV,ACL
学术活动
发表作品
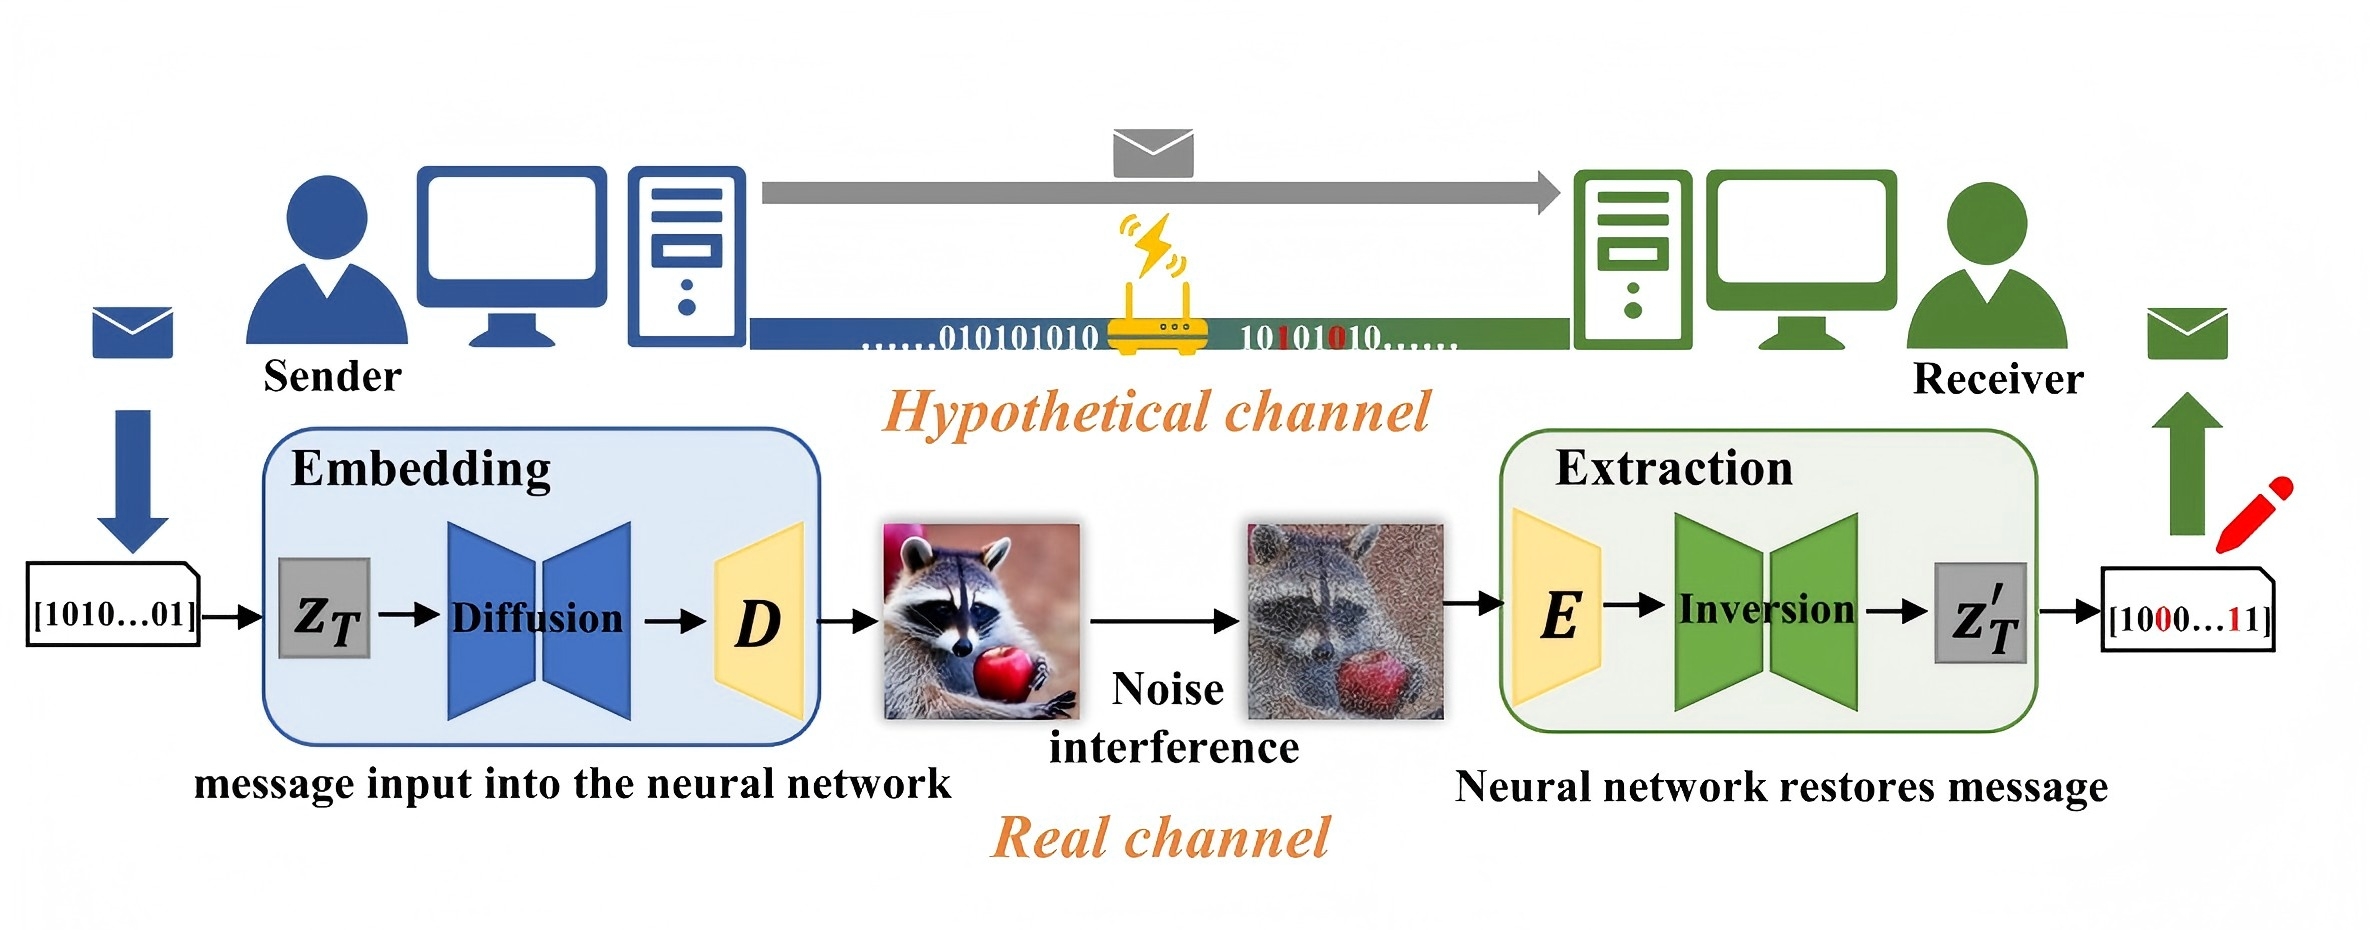 | Gaussian Shannon: High-Precision Diffusion Model Watermarking Based on Communication Yi Zhang, Hongbo Huang, Liang-Jie Zhang The IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR2026 ).CCF-A [论文][代码][项目网页 ] |
|---|
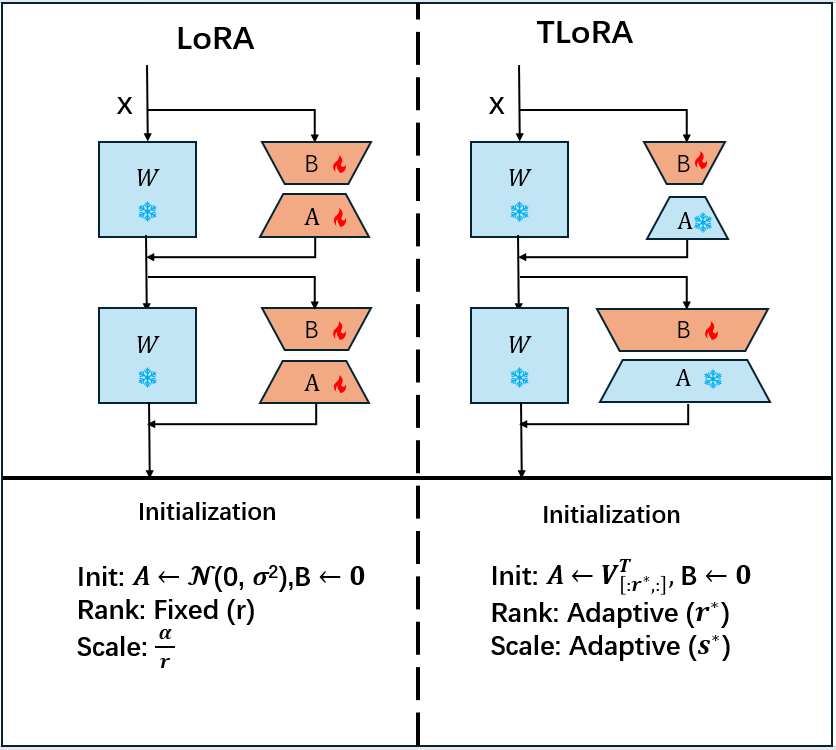 | TLoRA: Task-aware Low Rank Adaptation of Large Language Models Weicheng Lin* Yi Zhang*(Co-first Author), Jiawei Dang, Liang-Jie Zhang The 64th Annual Meeting of the Association for Computational Linguistics (ACL2026 ).CCF-A [论文][代码][项目网页 ] |
|---|
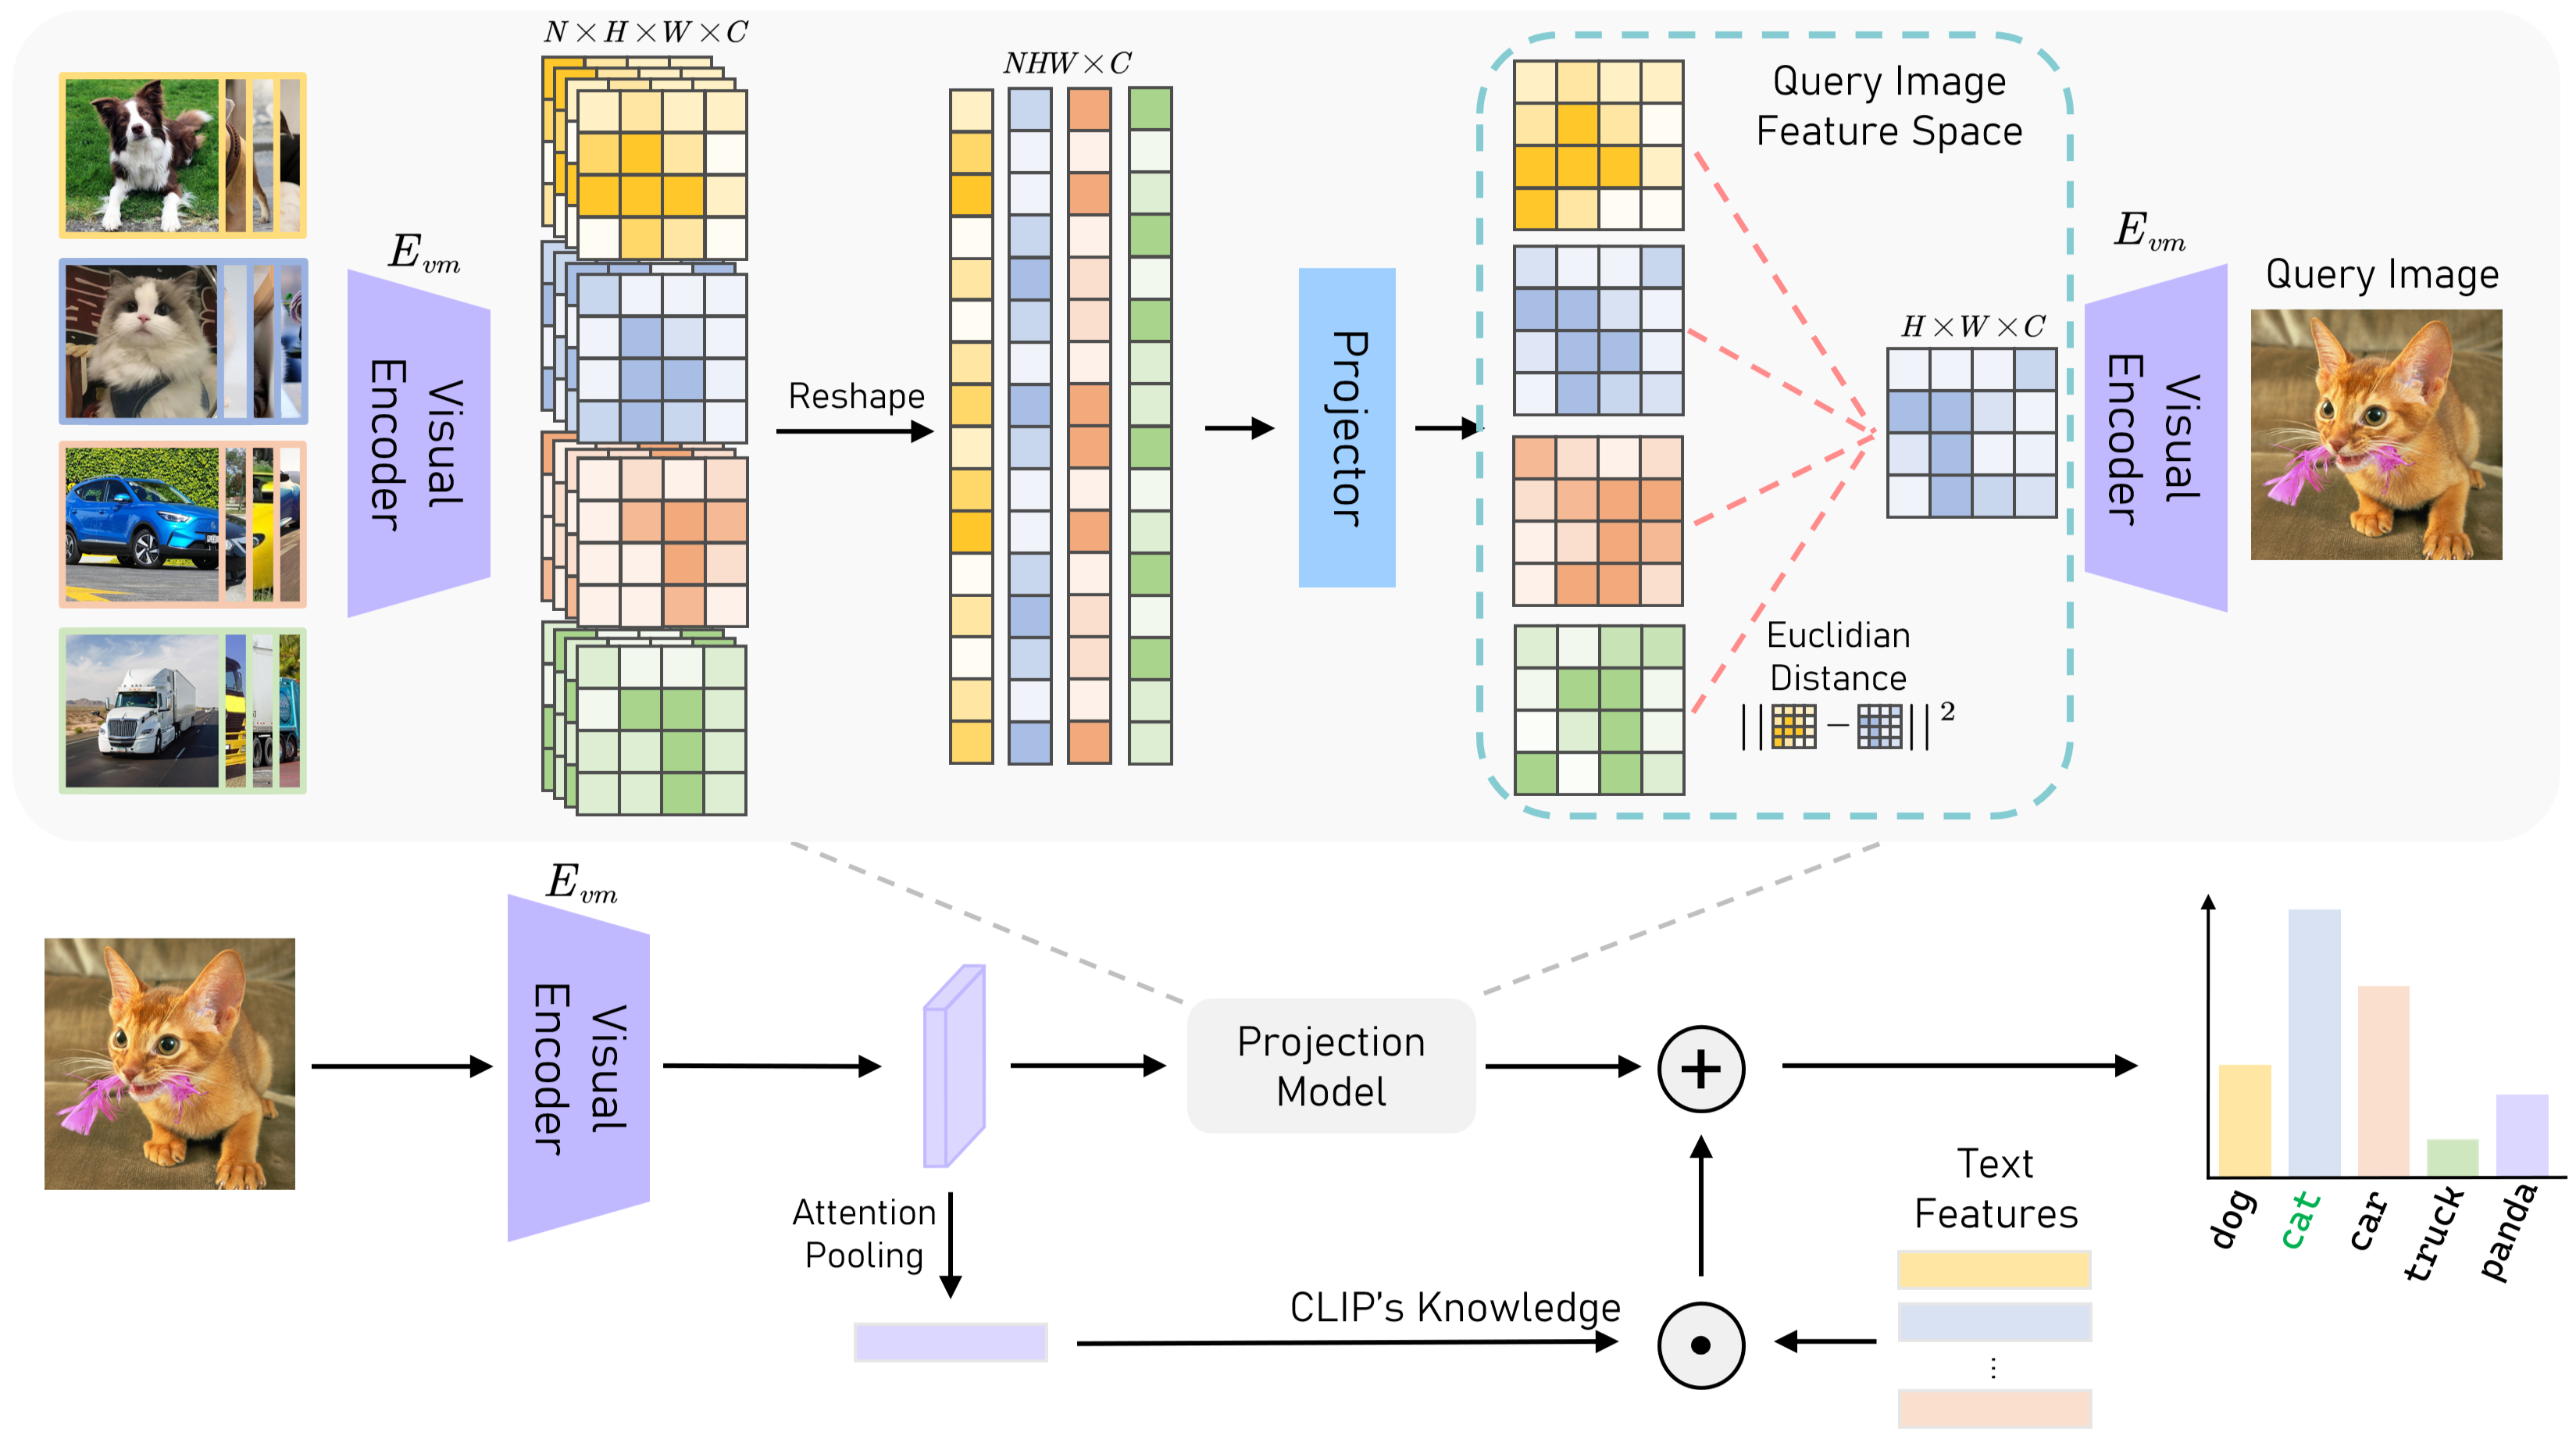 | Feature Projection Learning for Better Vision-Language Reasoning Yi Zhang , Weicheng Lin, Liang-Jie Zhang 2026 IEEE International Conference on Acoustics, Speech, and Signal Processing (ICASSP2026) CCF-B [论文] |
|---|
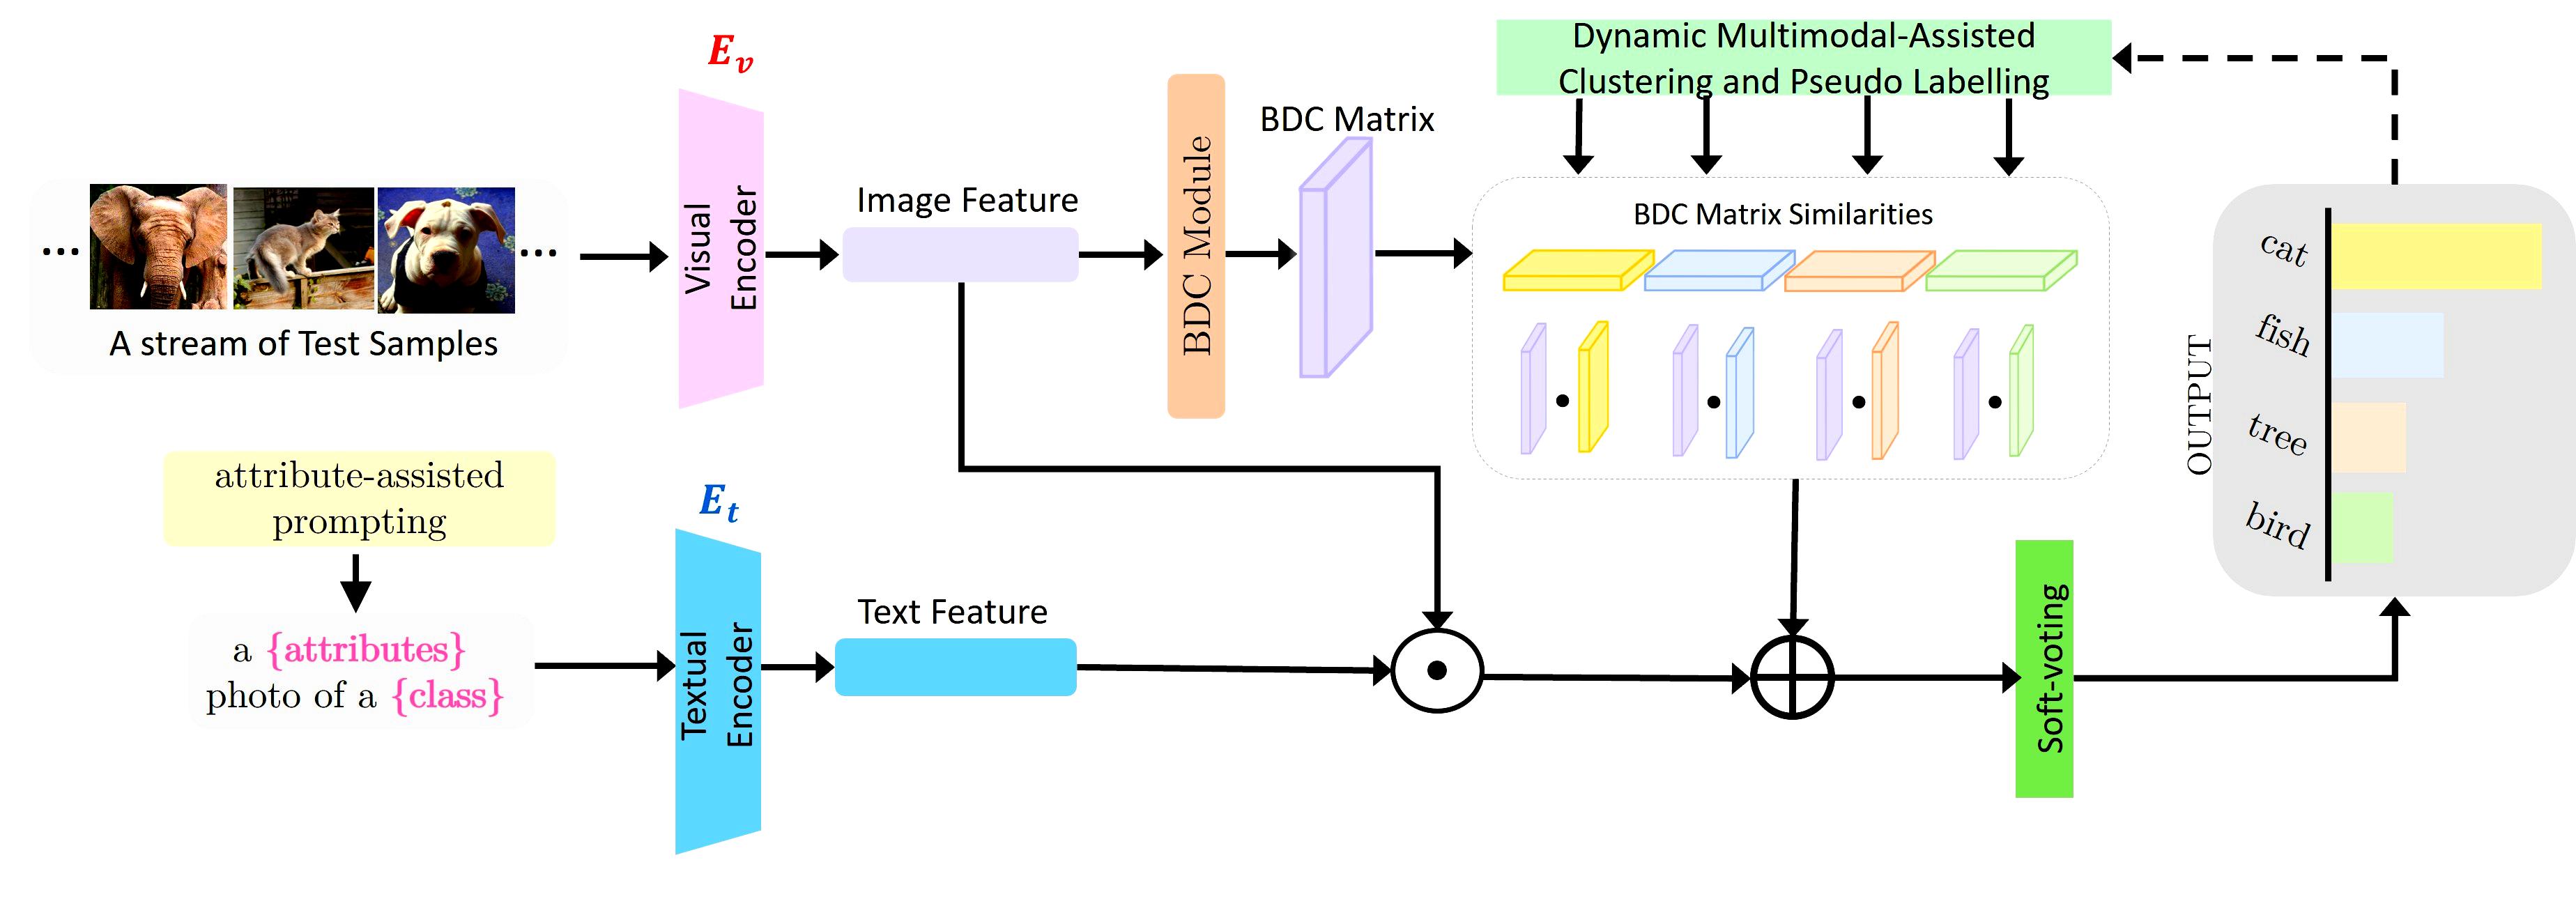 | Training-Free Test-Time Adaptation with Brownian Distance Covariance in Vision-Language Models Yi Zhang , Chun-Wun Cheng, Angelica I Aviles-Rivero, Zhihai He, Liang-Jie Zhang 2026 IEEE International Conference on Acoustics, Speech, and Signal Processing (ICASSP2026) CCF-B [论文] |
|---|
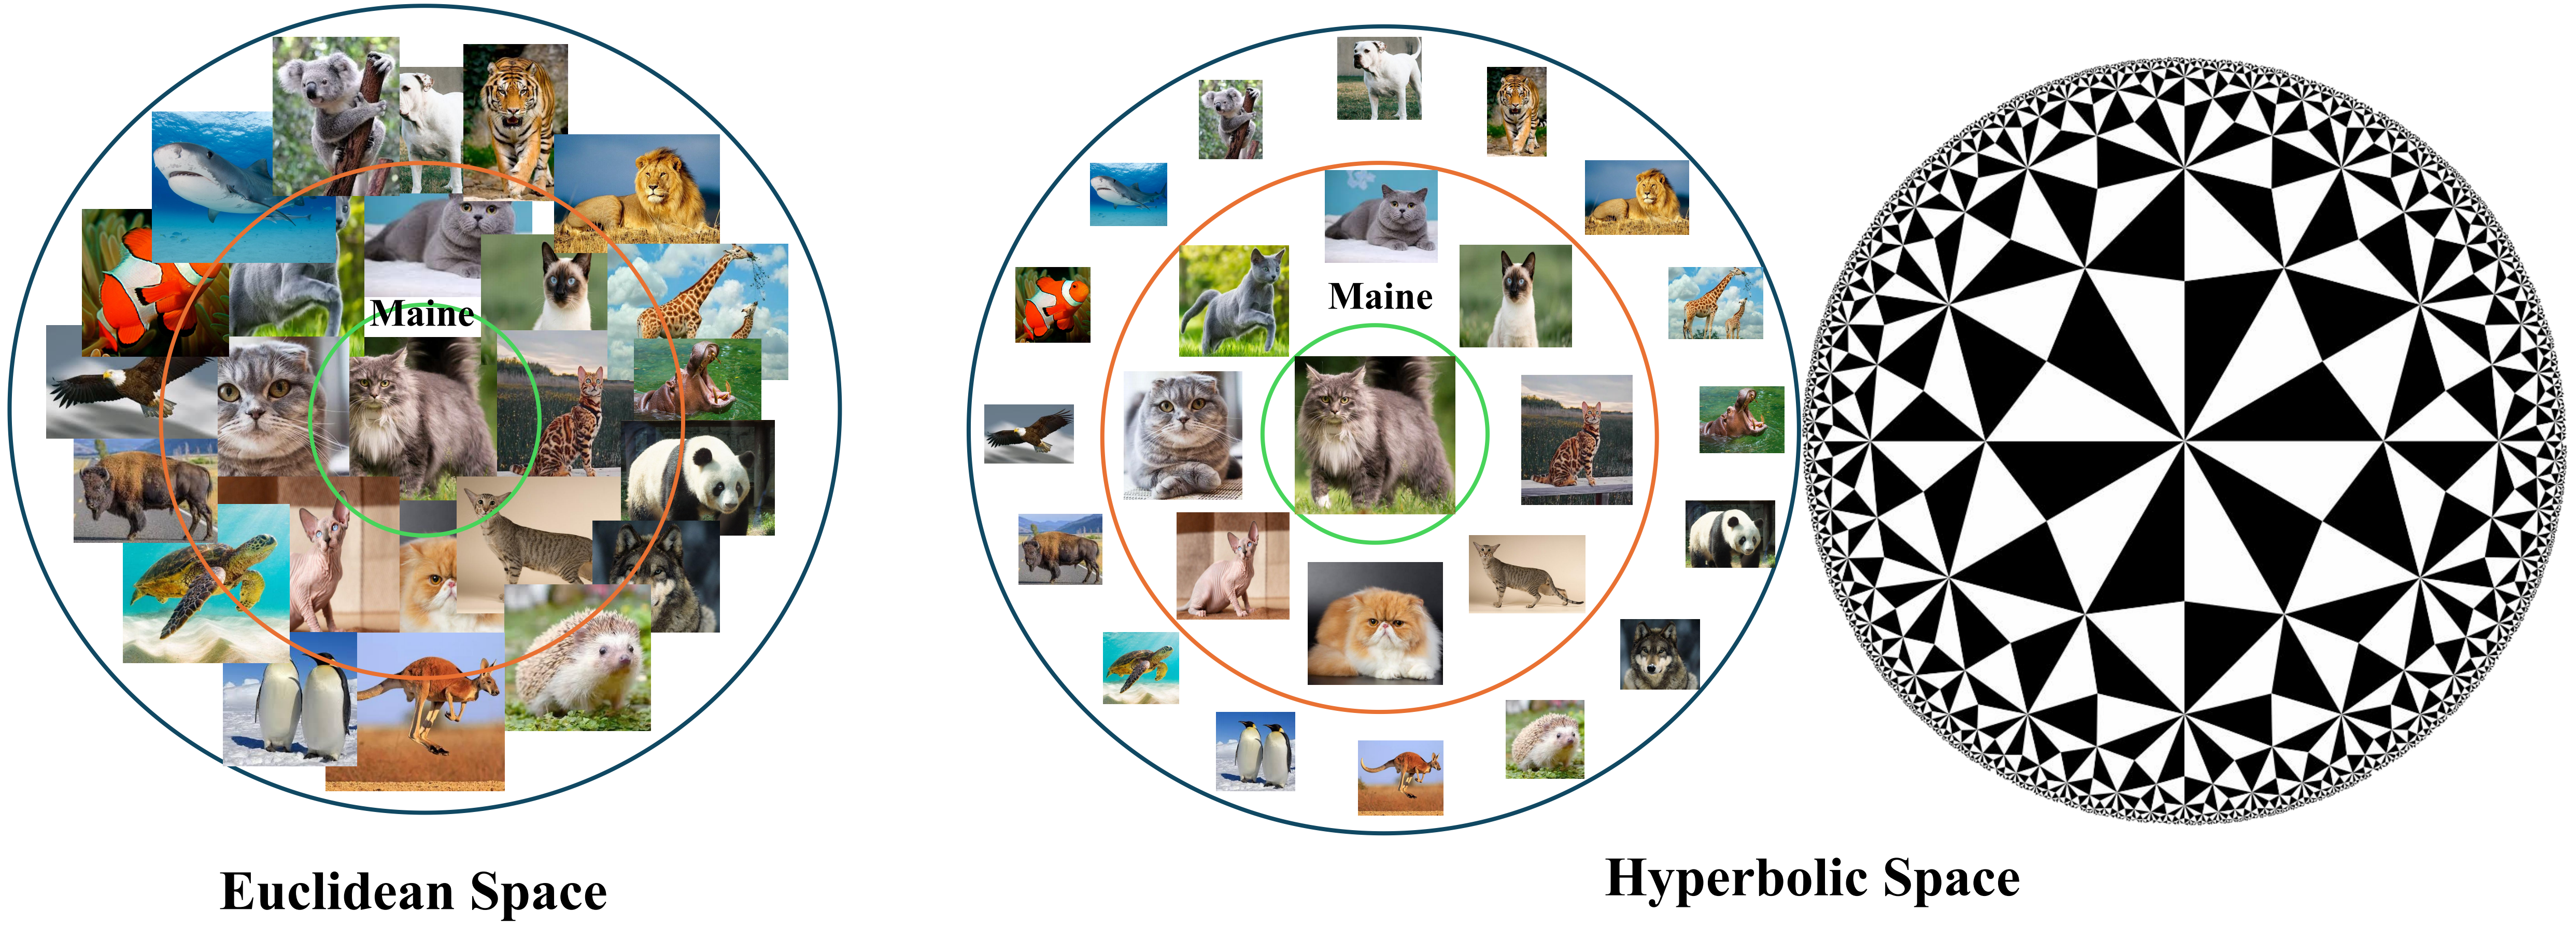 | Training-Free Dual Hyperbolic Adapters for Better Cross-Modal Reasoning Yi Zhang, Chun-Wun Cheng, Junyi He, Ke Yu, Yushun Tang, Carola-Bibiane Schönlieb, Angelica I Aviles-Rivero IEEE Transactions on Mutltimedia(TMM).CCF-A SCI中科院一区 [论文] |
|---|
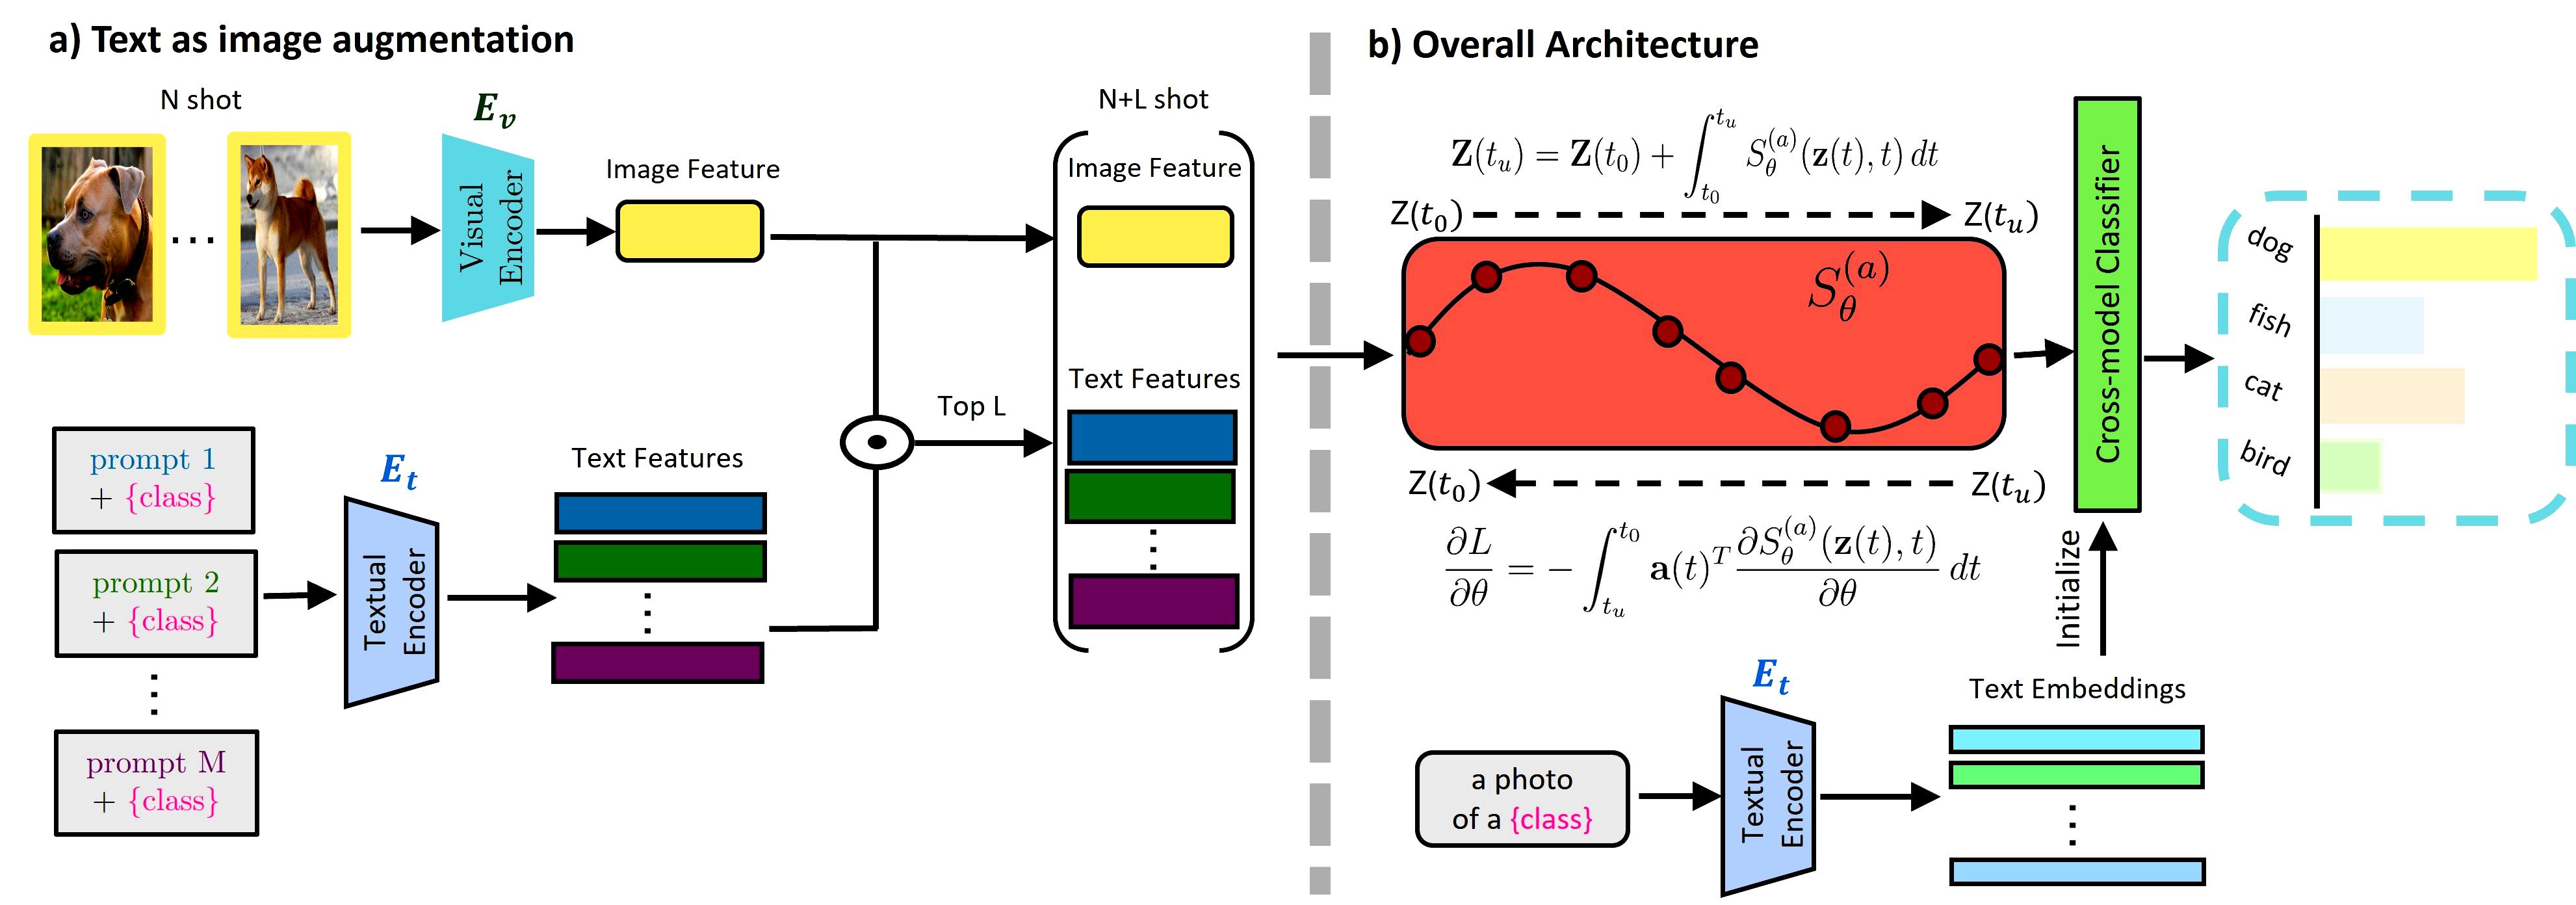 | Cross-Modal Few-Shot Learning with Second-Order Neural Ordinary Differential Equations Yi Zhang, Chun-Wun Cheng, Junyi He, Zhihai He, Carola-Bibiane Schönlieb, Yuyan Chen, Angelica I Aviles-Rivero AAAI Conference on Artificial Intelligence (AAAI2025). Oral Paper, 接收率=4.6\%, CCF-A [论文][Code][Project Page ] |
|---|
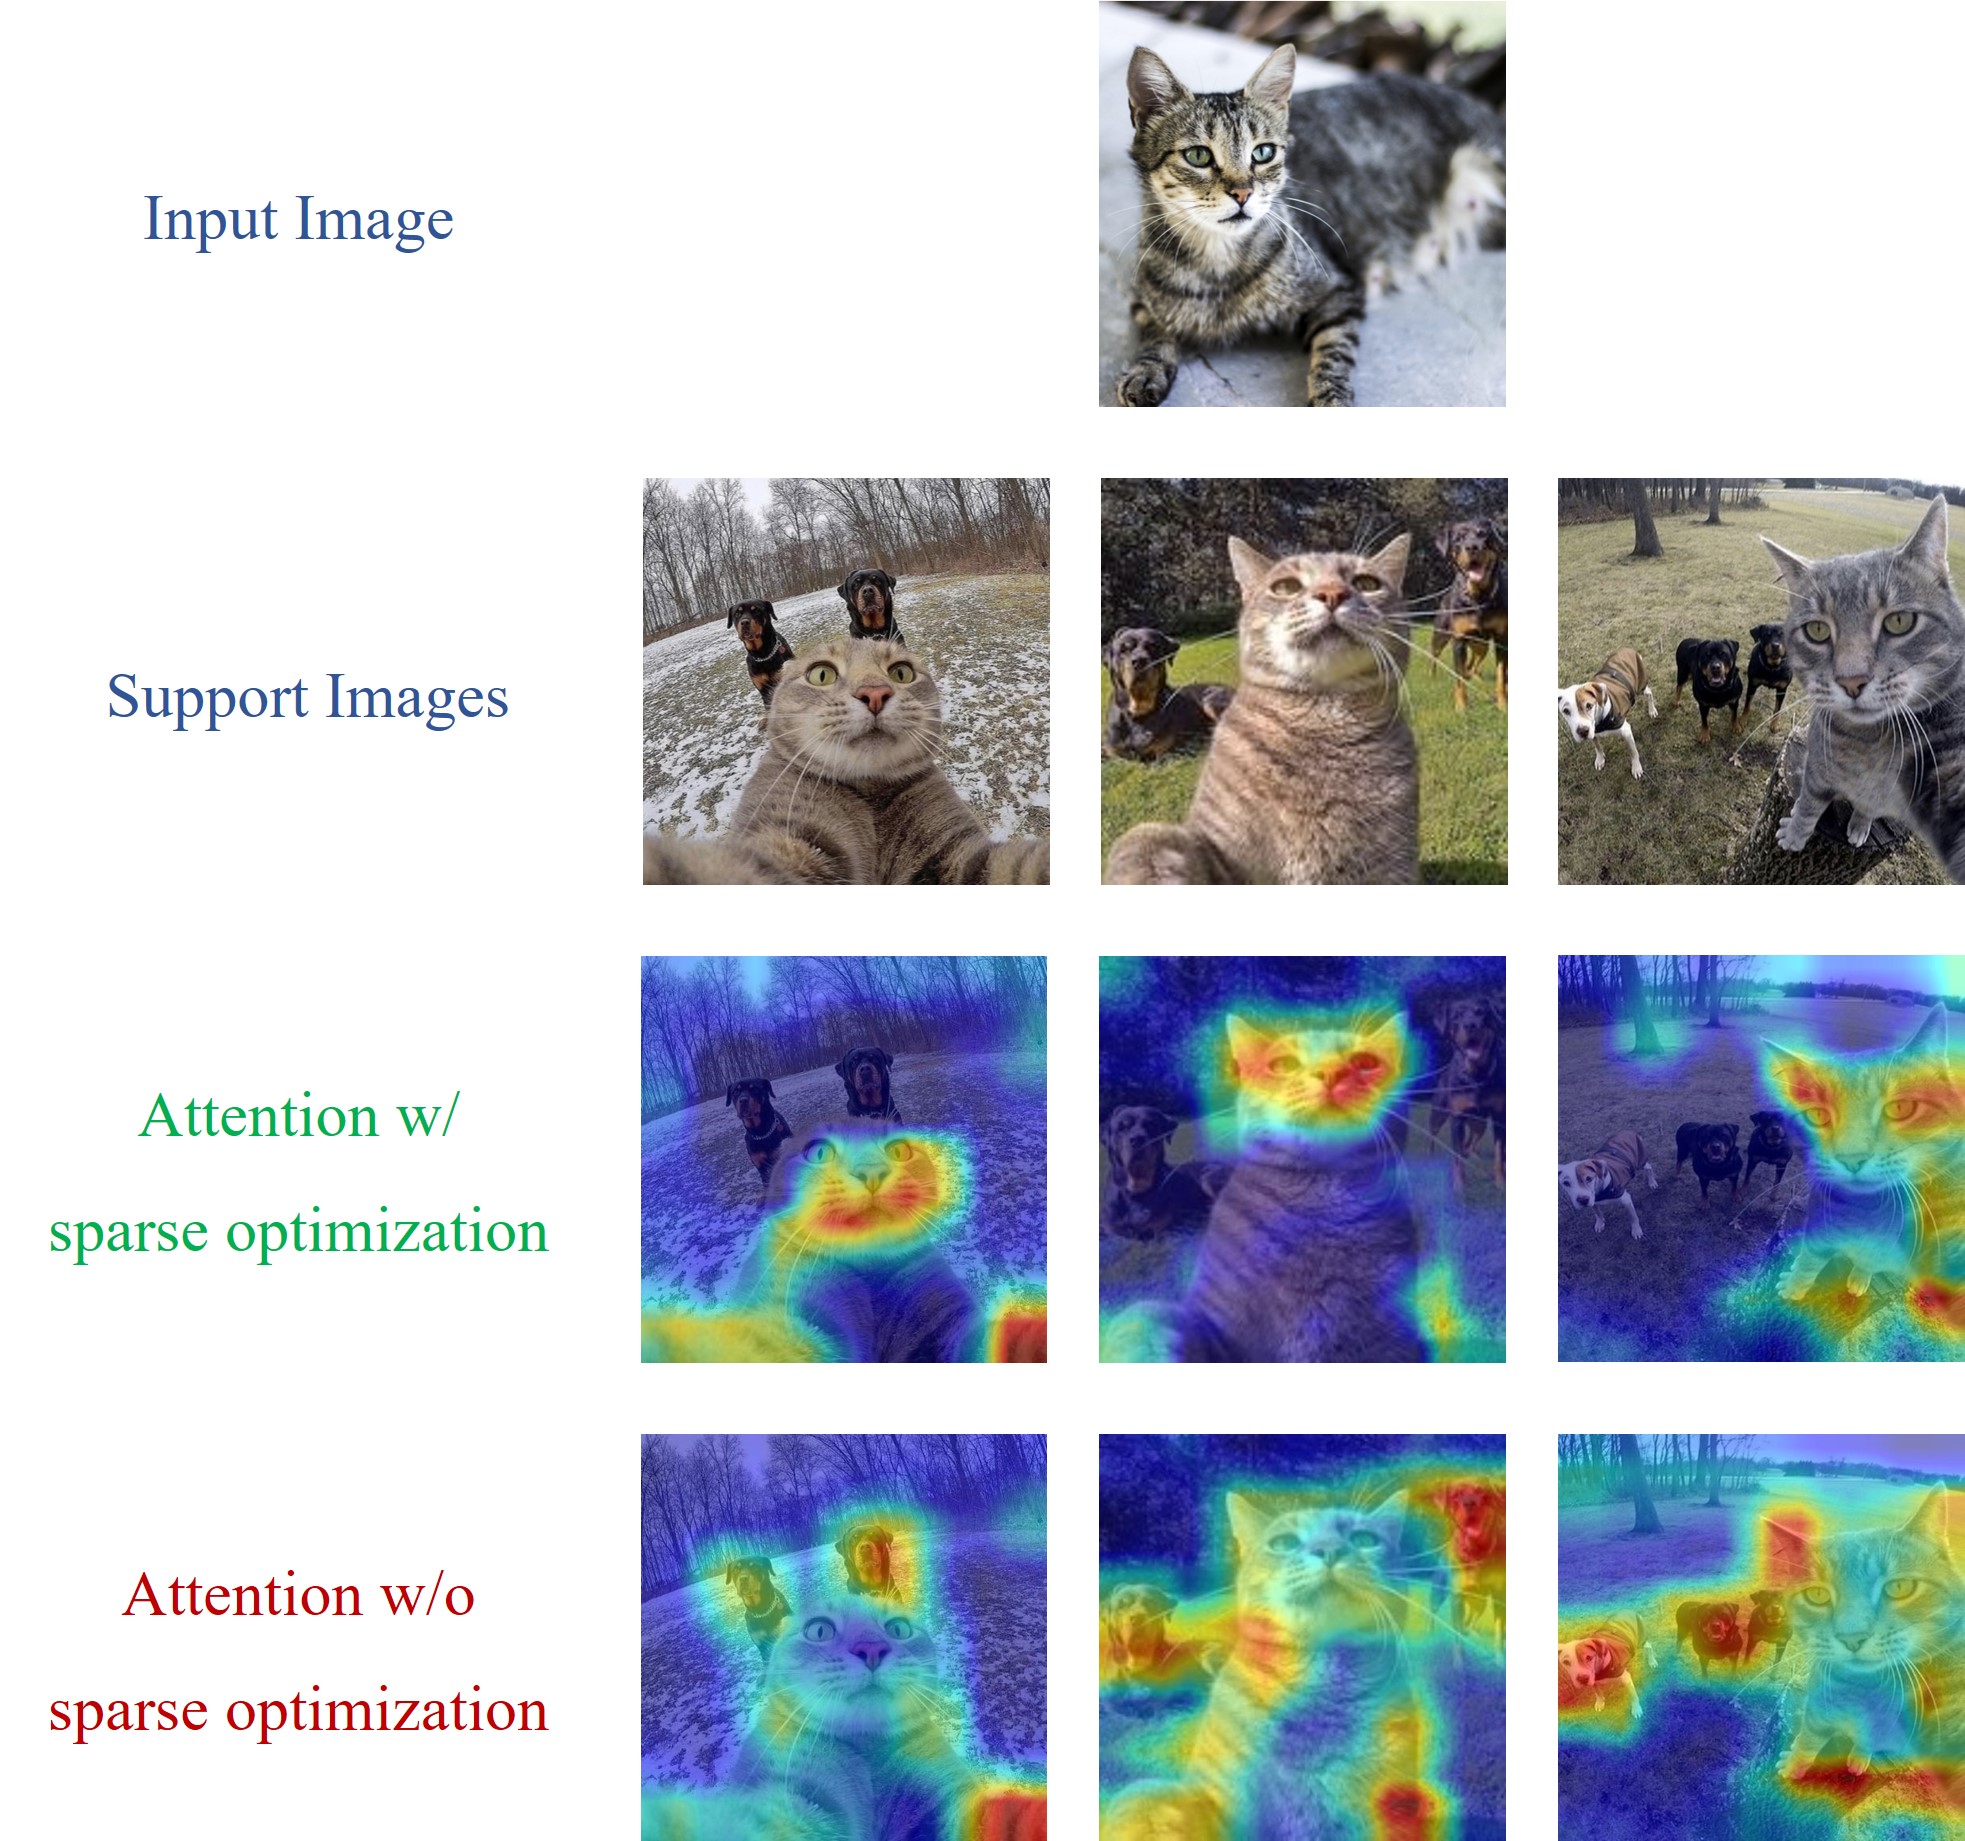 | Training-Free Feature Reconstruction with Sparse Optimization for Vision-Language Models Yi Zhang, Ke Yu, Angelica I Aviles-Rivero, Jiyuan Jia, Yushun Tang, Zhihai He ACM International Conference on Multimedia ( [论文] |
|---|
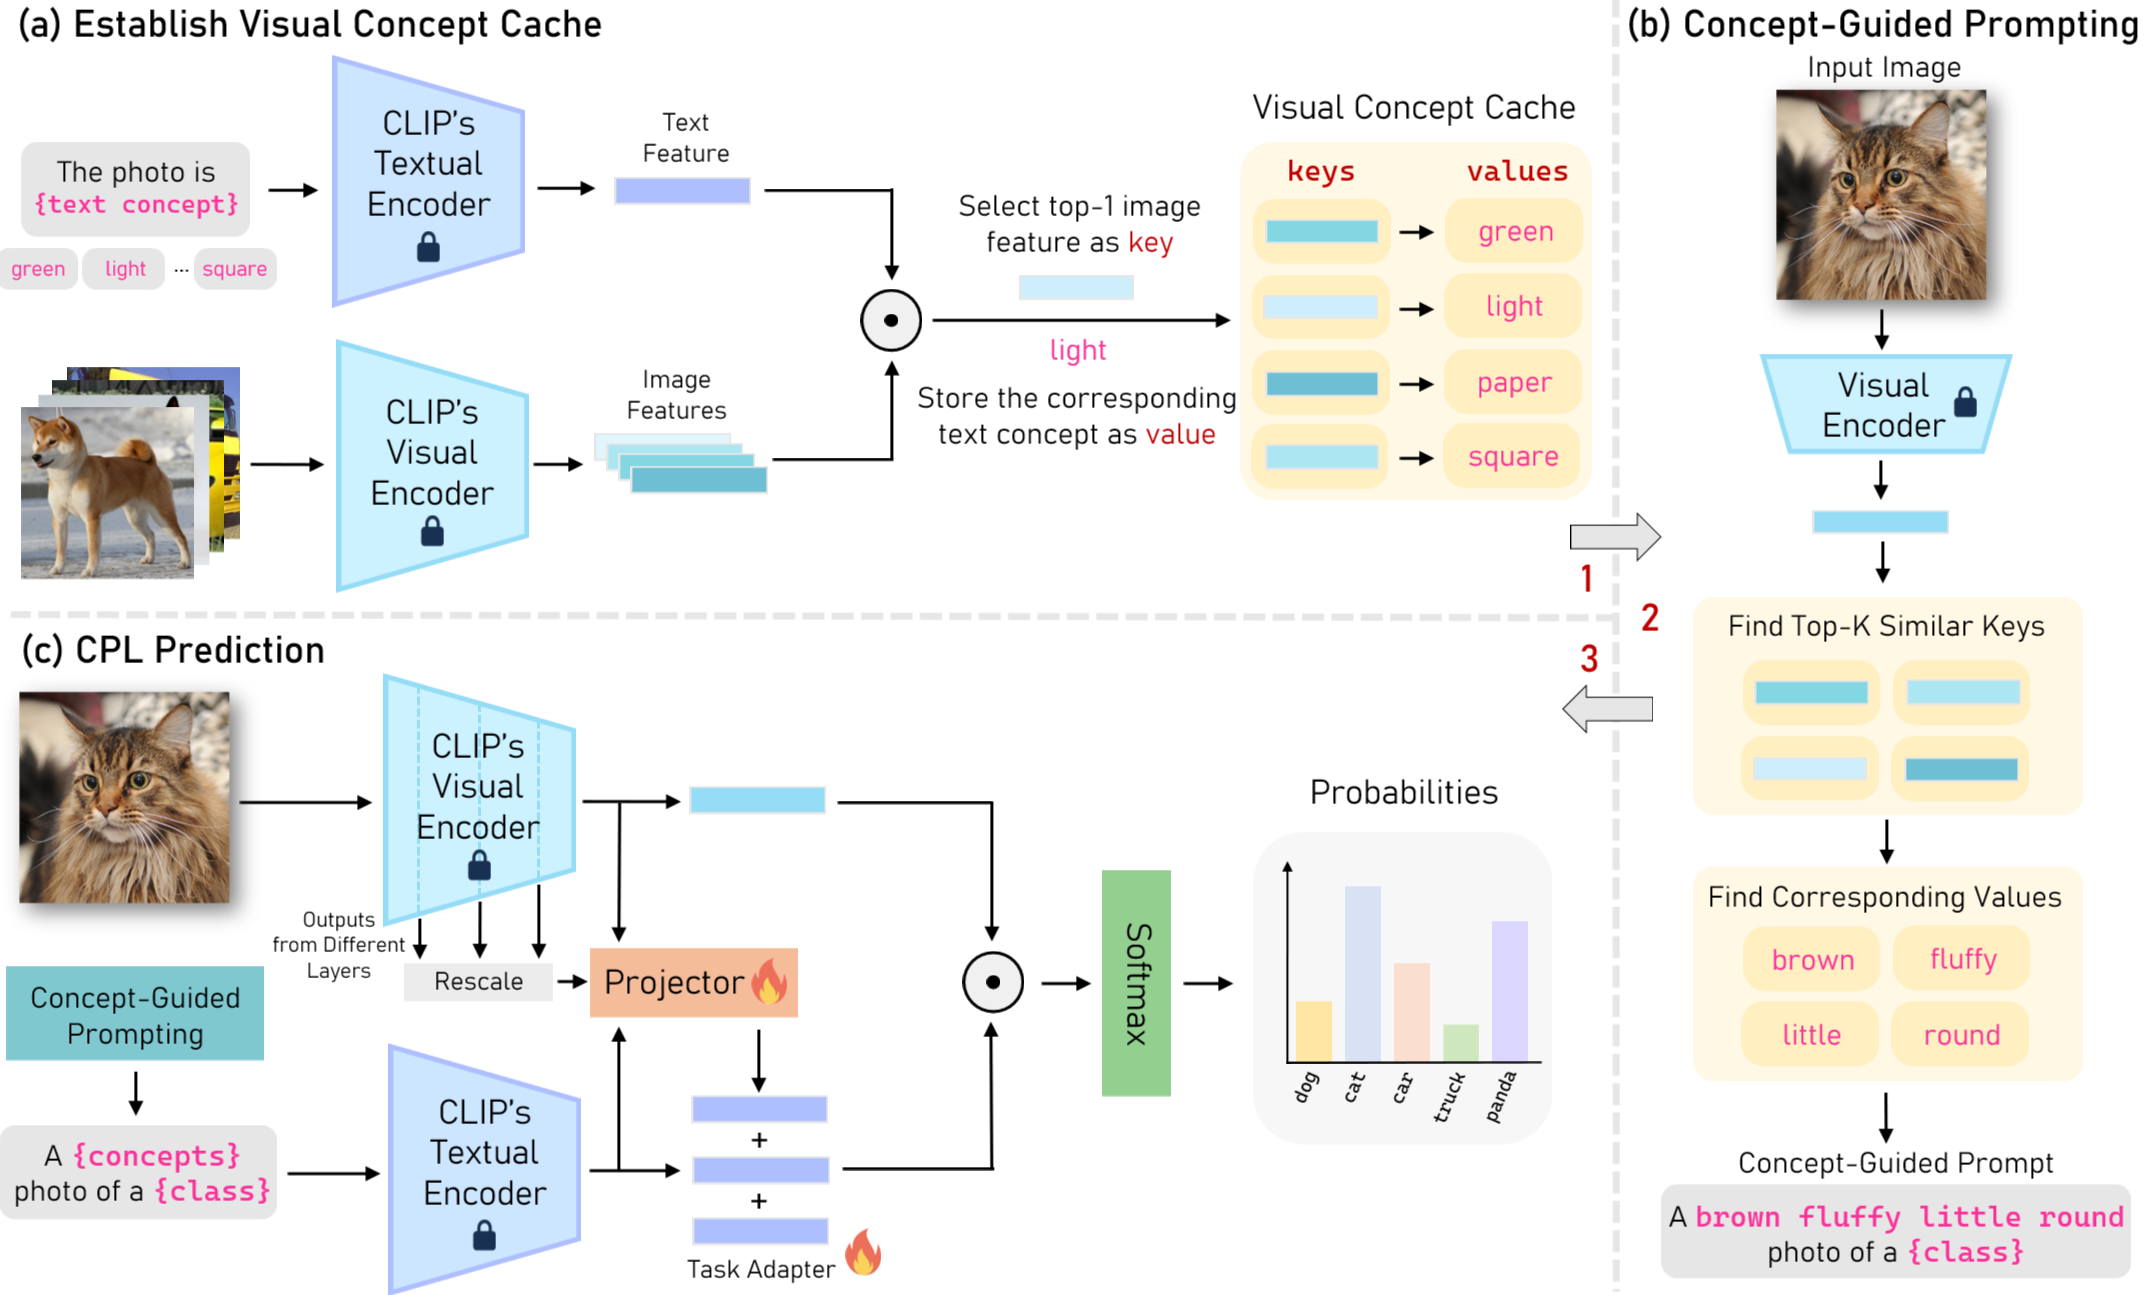 | Concept-Guided Prompt Learning for Generalization in Vision-Language Models Yi Zhang, Ce Zhang, Ke Yu, Yushun Tang, and Zhihai He The AAAI Conference on Artificial Intelligence(AAAI2024), CCF-A [论文] |
|---|
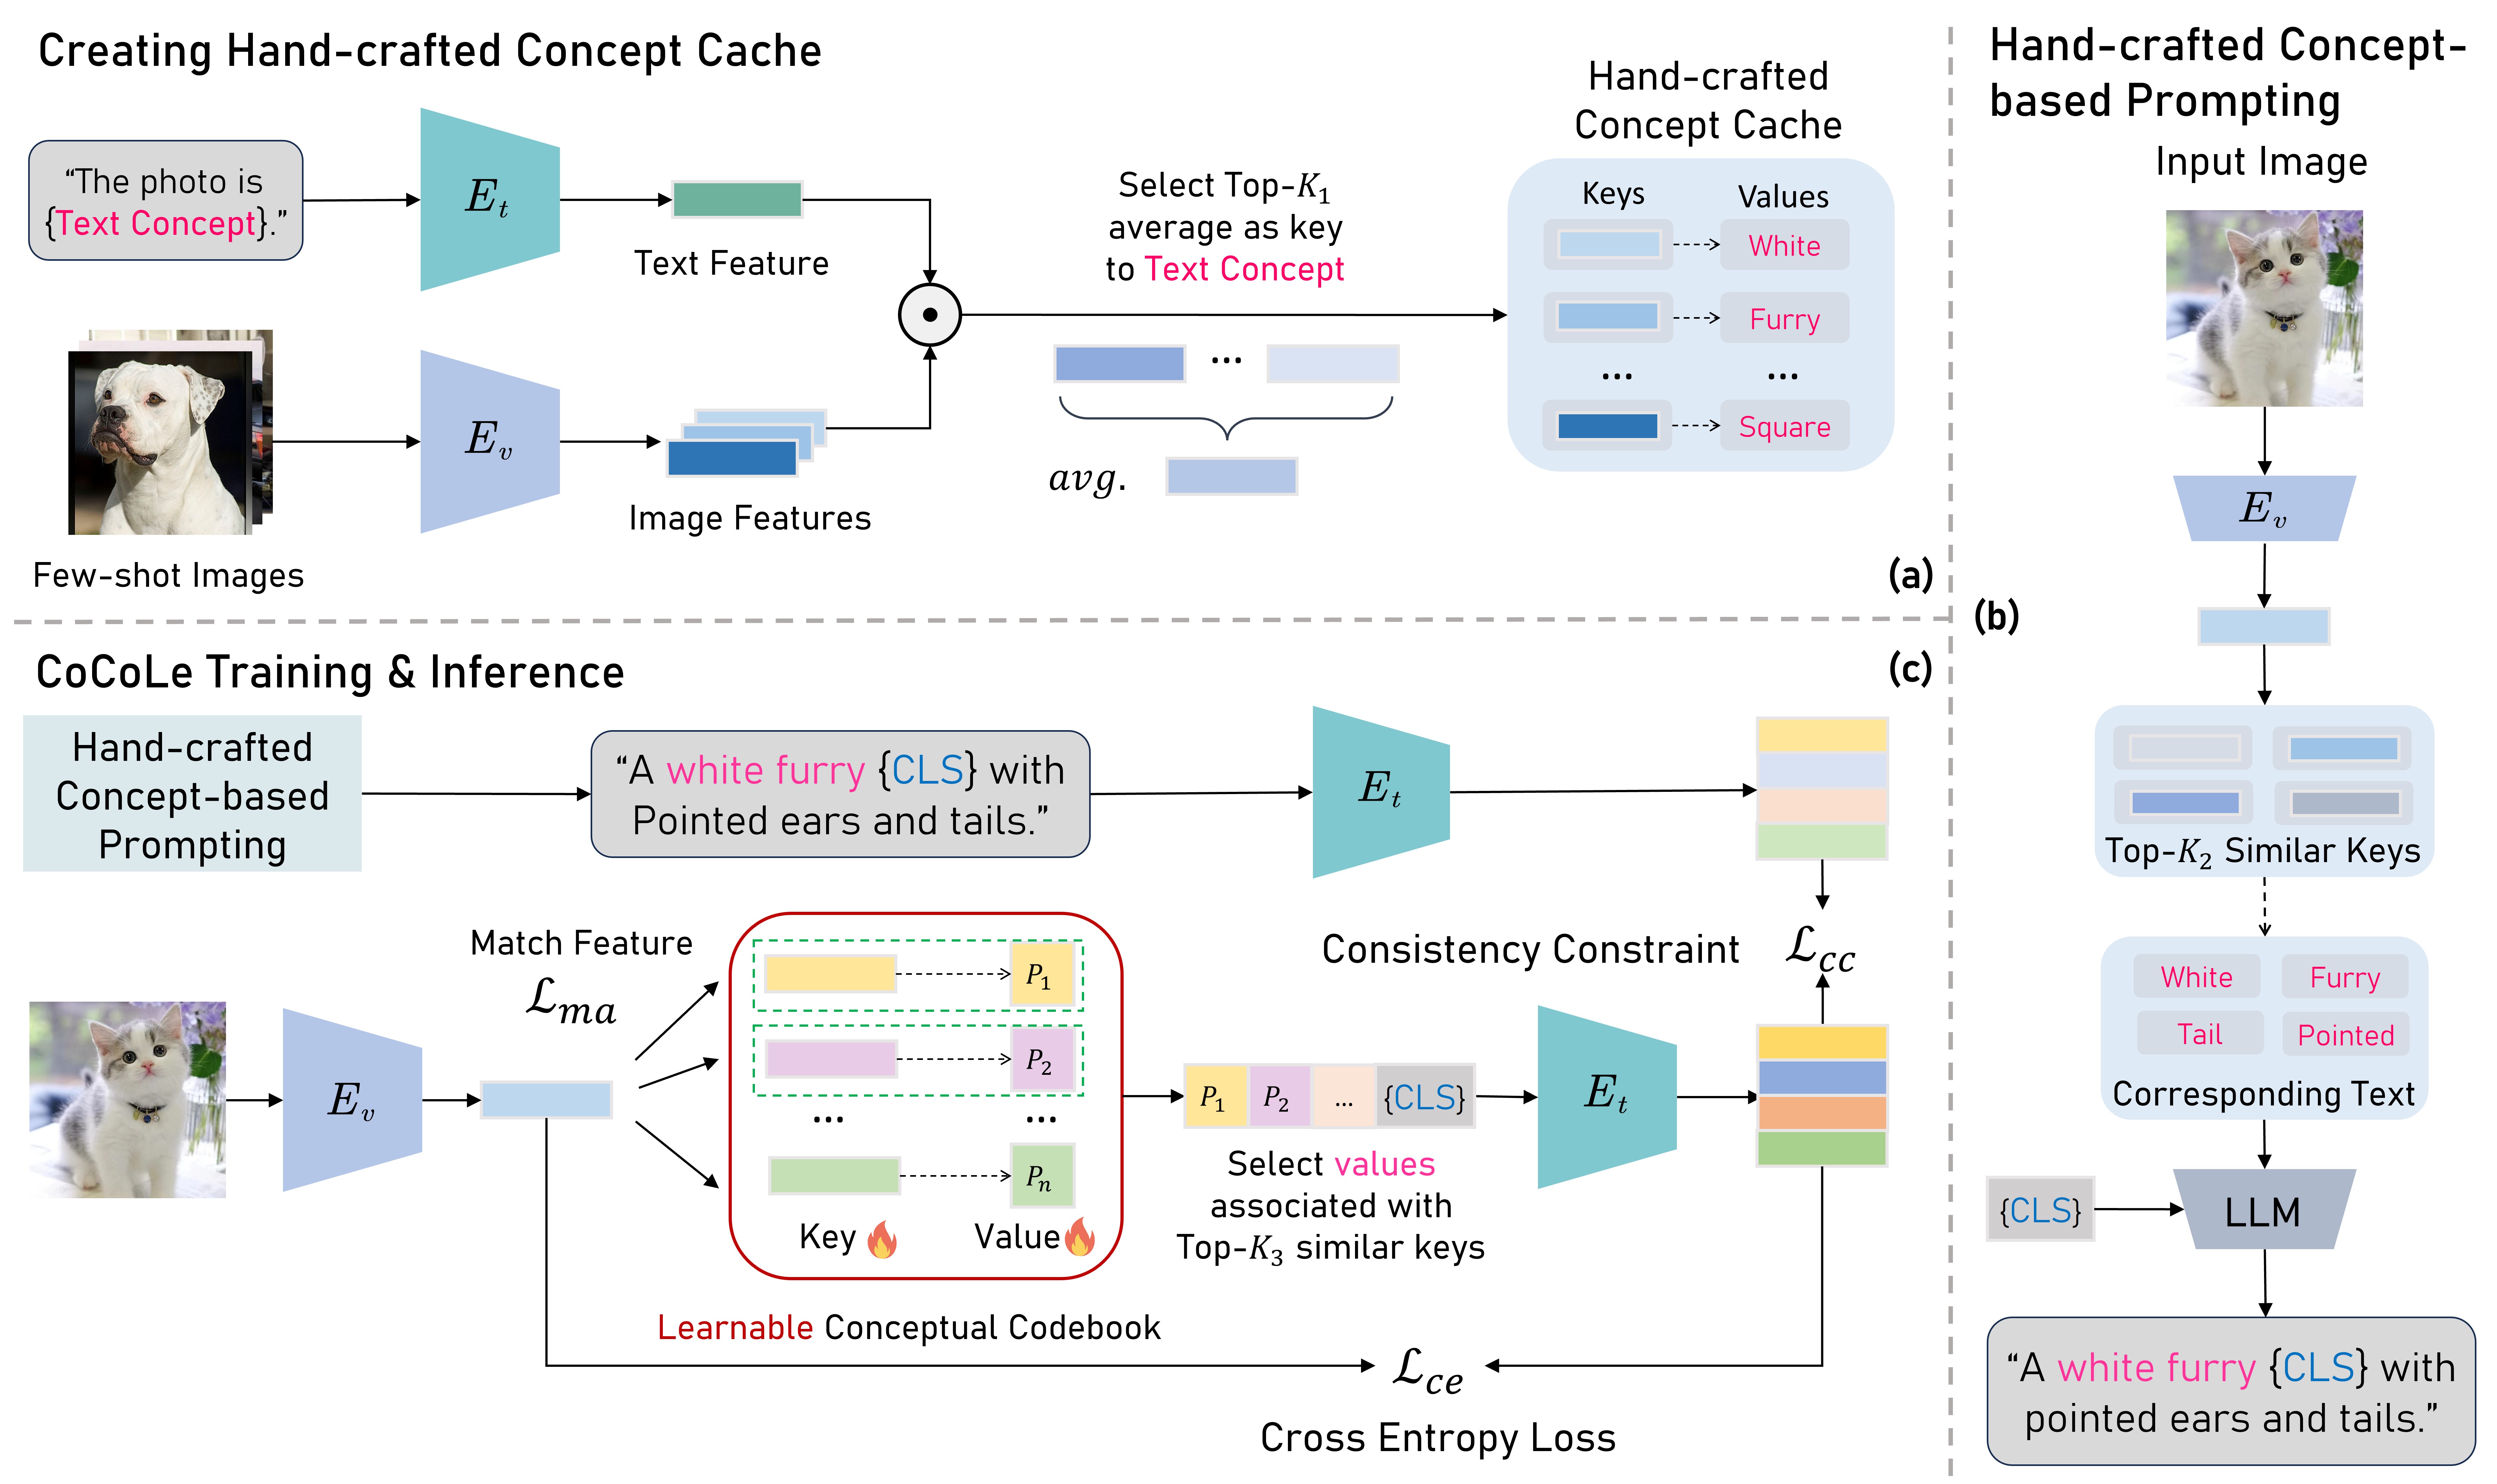 | Conceptual Codebook Learning for Vision-Language Models Yi Zhang , Ke Yu, Siqi Wu and Zhihai He European Conference on Computer Vision (ECCV2024) CCF-B [论文] |
|---|
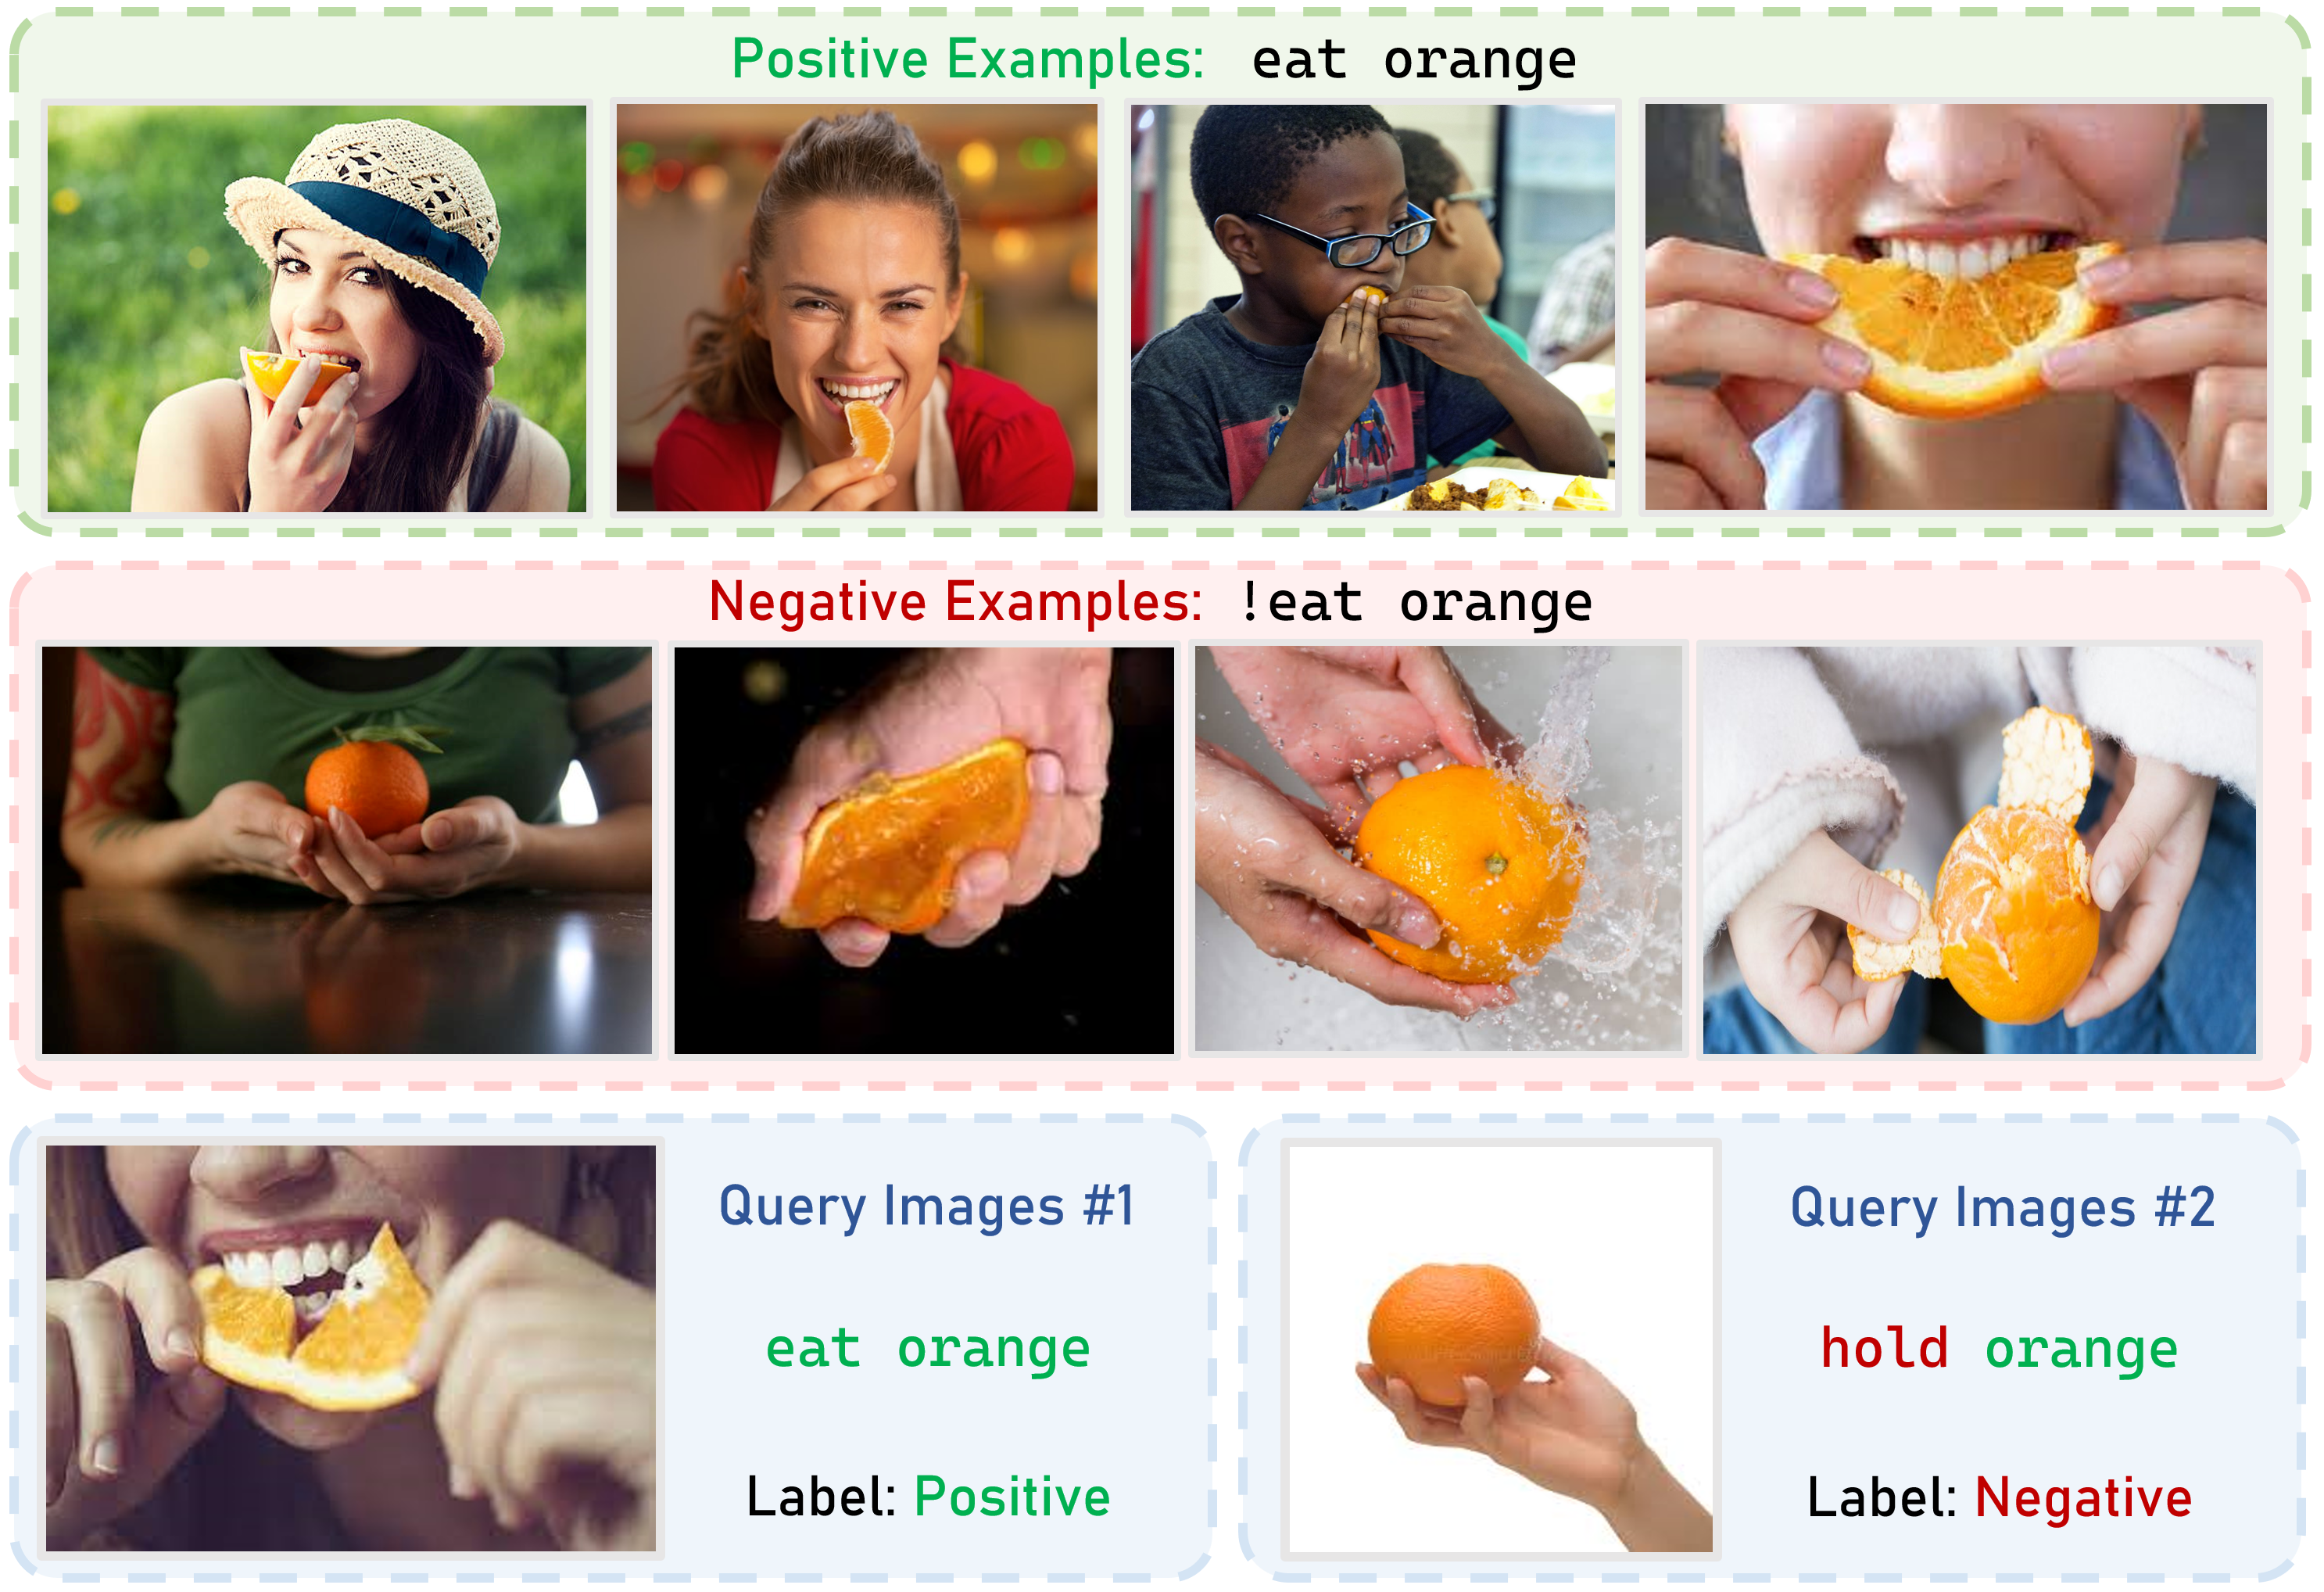 | Test-time Distribution Learning Adapter for Cross-Modal Visual Reasoning Yi Zhang , Ce Zhang 2024 IEEE International Conference on Acoustics, Speech, and Signal Processing (ICASSP2024) CCF-B [论文] |
|---|
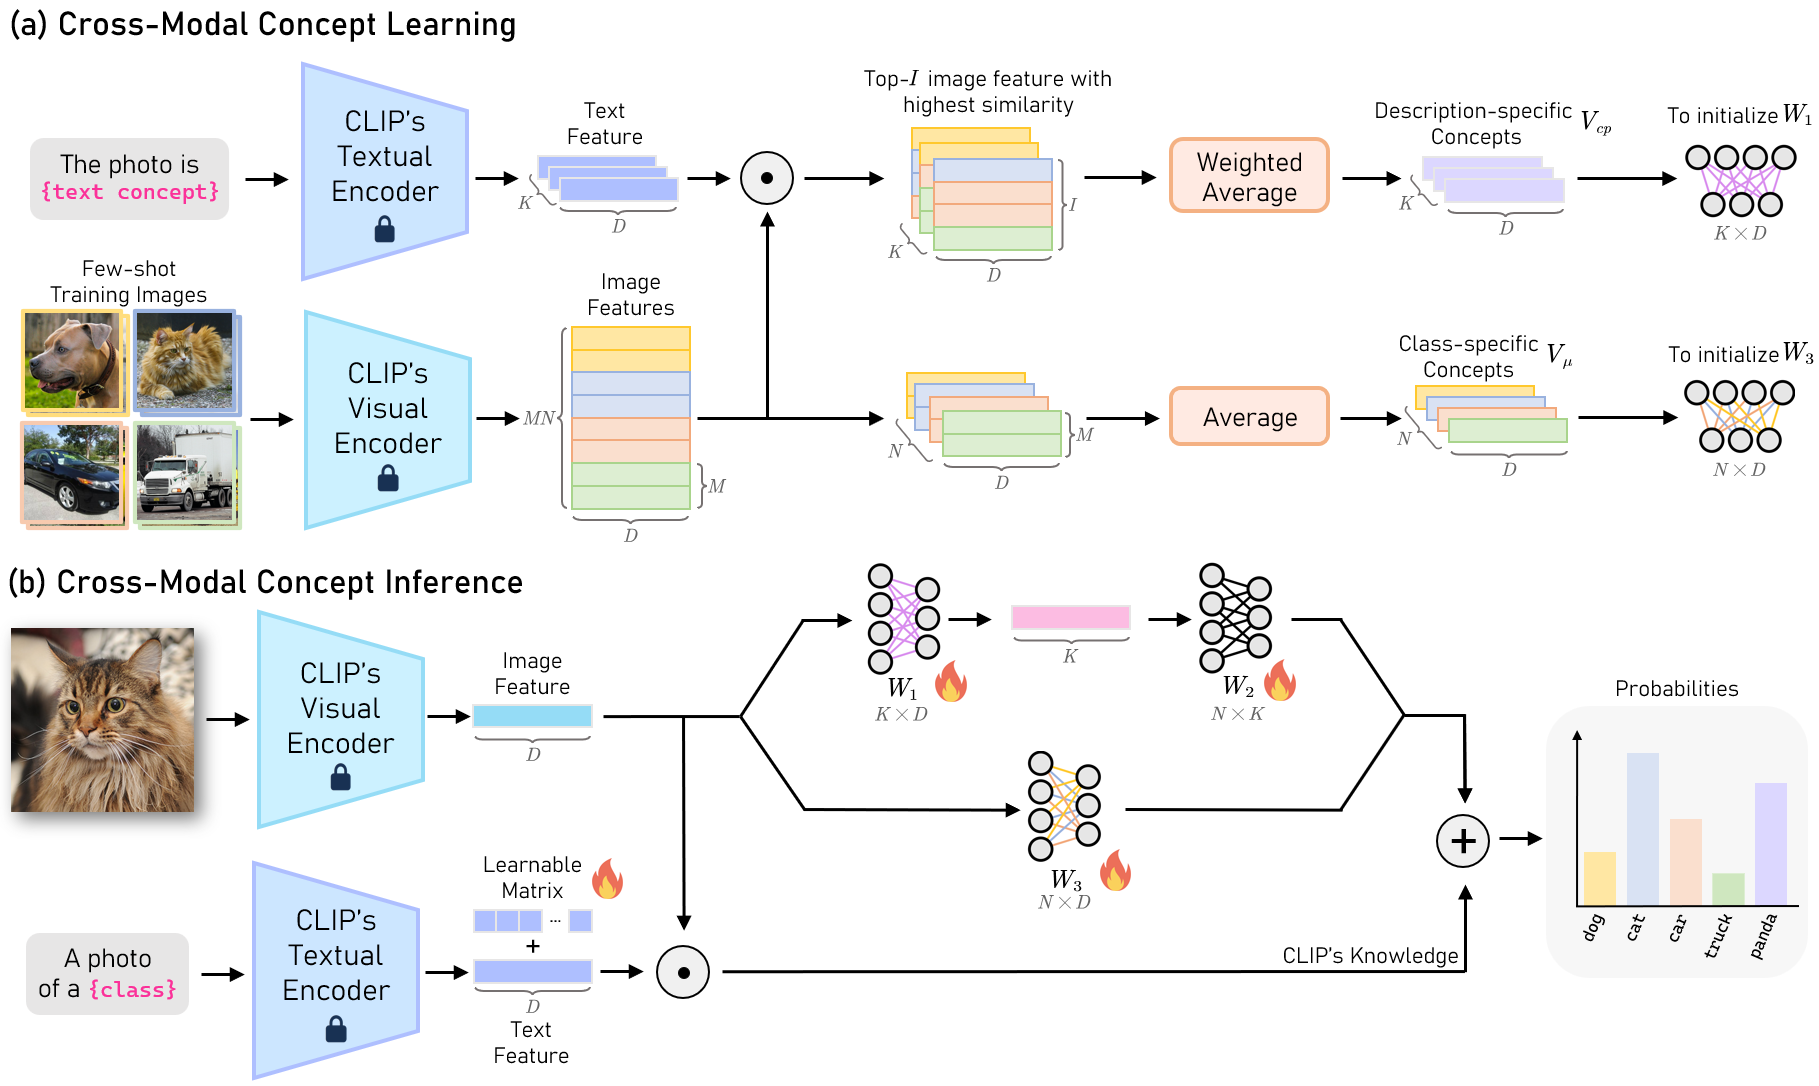 | Cross-Model concept learning and reference for Vision-Language Models Yi Zhang , Ce Zhang, Yushun Tang, Zhihai He Neurocomputing. SCI 中科院二区 [论文] |
|---|
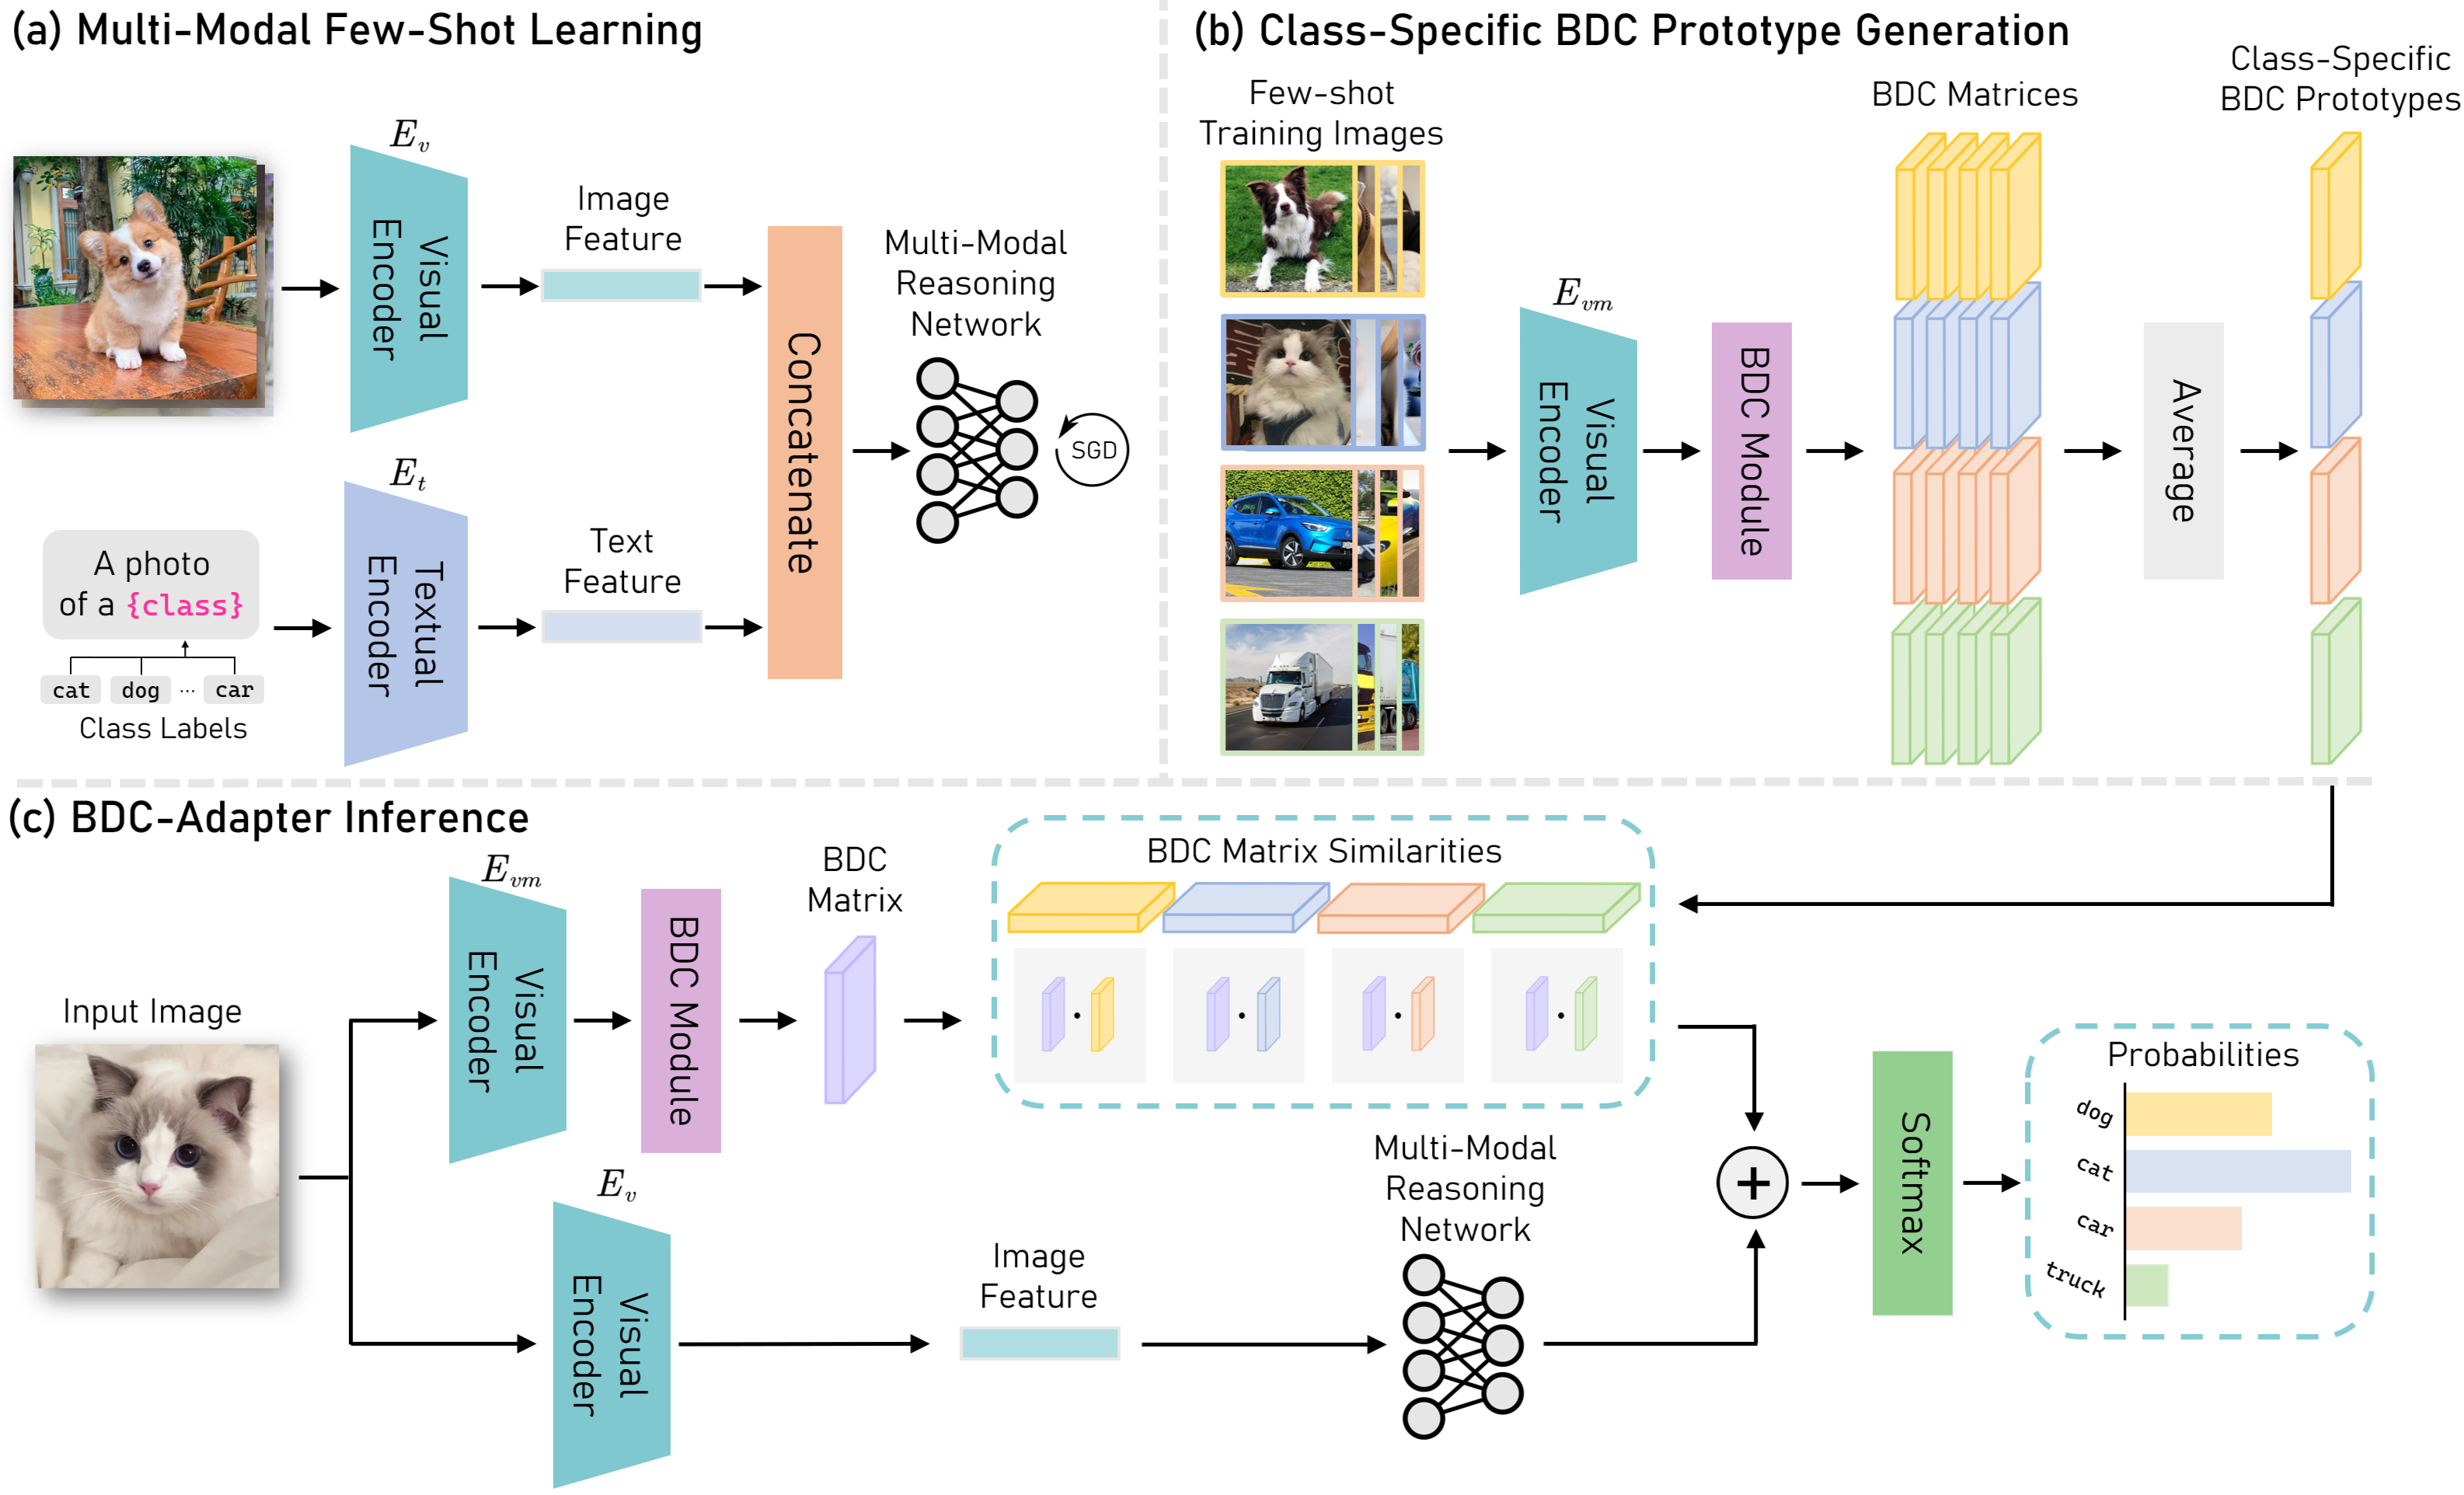 | BDC-Adapter: Brownian Distance Covariance for Better Vision-Language Reasoning Yi Zhang , Ce Zhang, Zihan Liao, Yushun Tang, Zhihai He British Machine Vision Conference (BMVC2023). CCF-C [论文] |
|---|
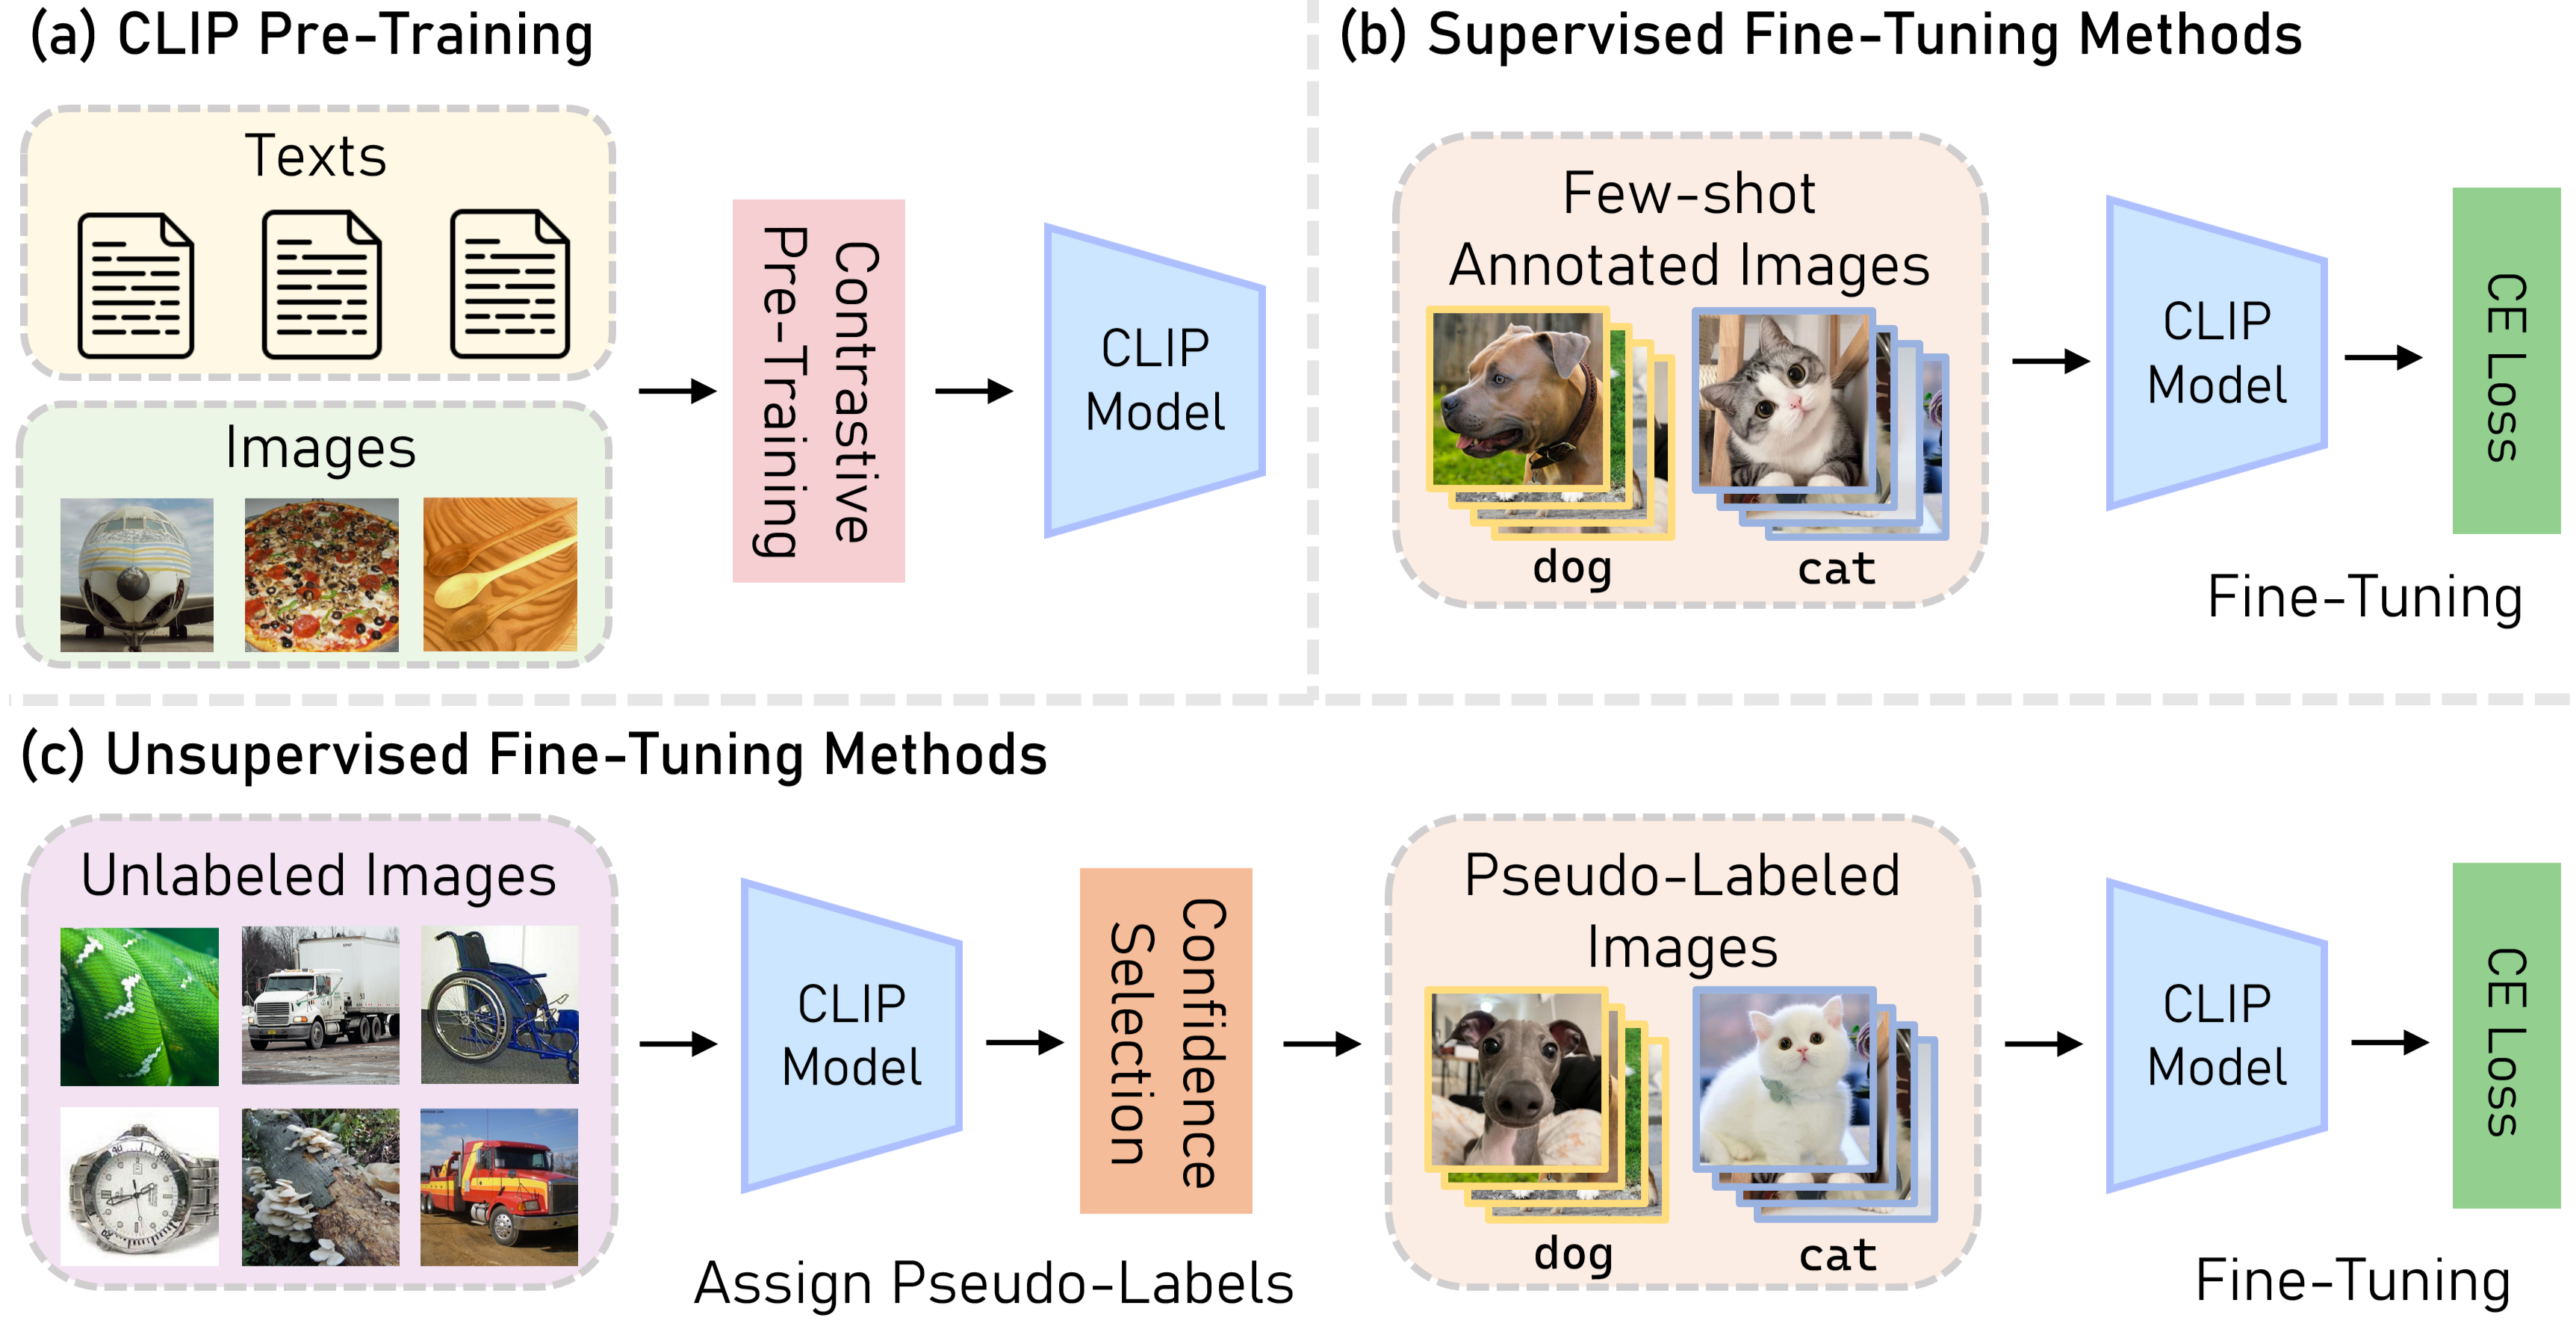 | Unsupervised Prototype Adapter for Vision-Language Models Yi Zhang , Ce Zhang, Xueting Hu, Zhihai He The 6th Chinese Conference on Pattern Recognition and Computer Visione (PRCV2023). CCF-C [论文] |
|---|
专业能力
- 编程语言:Python, Pytorch,C++,SQL
- 专业工具:Latex, Matlab
教学
- 《软件工程》本科
- 《软件工程实训》本科
- 《强化学习》研究生